
Galera-Cluster nach Reboot: warum der Node nicht sauber zurückkam
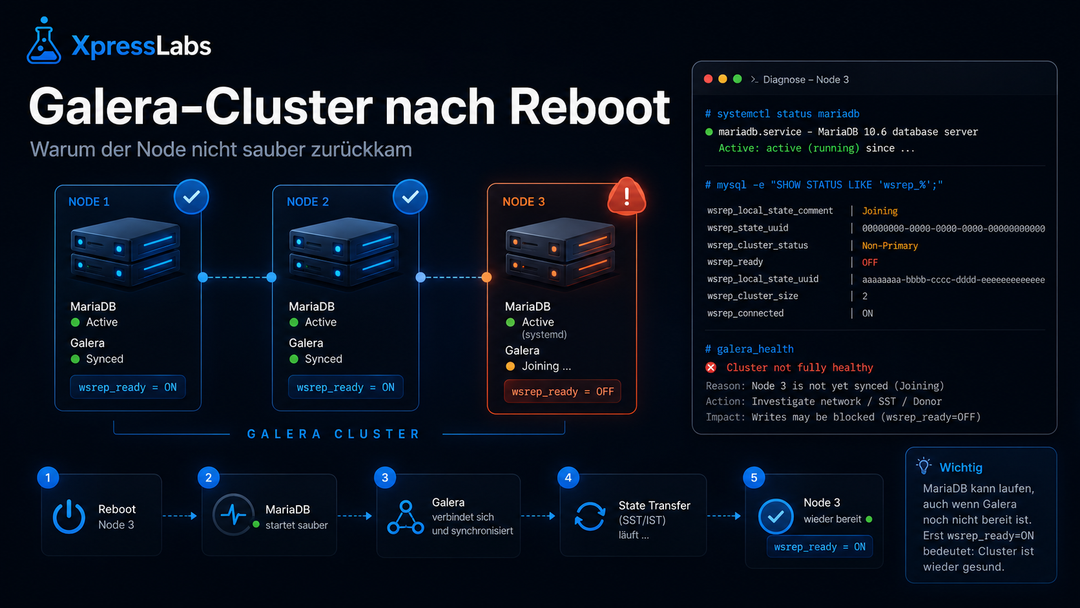
Nach einem Reboot sah MariaDB erst einmal aktiv aus. Trotzdem war der Galera-Node nicht sauber zurück im Cluster. Genau solche Fälle zeigen, warum systemd grün nicht reicht.
Es gibt Fehler, die sehen im ersten Moment gar nicht so schlimm aus.
Der Server ist wieder online.
SSH geht.mariadb.service ist aktiv.
Das Monitoring wirkt erstmal nicht komplett rot.
Und trotzdem stimmt etwas nicht.
Genau so ein Fall ist bei meinem Galera-Setup nach einem Reboot aufgetaucht. Auf dem Papier war der Dienst wieder da. Aus Cluster-Sicht war der Node aber nicht sauber zurück. Und das ist genau die Sorte Fehler, die ich nicht mag: nicht komplett tot, aber auch nicht wirklich gesund.
Gerade bei Galera ist das gefährlich, weil man sich von einem grünen systemctl status mariadb sehr leicht beruhigen lässt.
Nur leider heißt:
mariadb.service activenicht automatisch:
Galera-Node ist synced, ready und Teil der Primary-KomponenteUnd genau darum geht diese Incident-Notiz.
Ausgangslage
Das Setup besteht aus mehreren VPS-Nodes und einem MariaDB/Galera-Cluster.
Der konkrete Fall trat nach Server-Restarts beziehungsweise Reboots auf. Der betroffene Node kam zwar wieder hoch, aber der Clusterzustand war nicht so sauber, wie ich es erwartet hätte.
Das ist keine exotische Enterprise-Situation. Das ist genau der normale kleine Infrastruktur-Alltag, den man gerne unterschätzt:
Node rebootet
Service startet
Cluster muss wieder zusammenfinden
Monitoring muss erkennen, ob der Zustand wirklich gesund ist
Und genau dort liegt der Unterschied zwischen “Dienst läuft” und “Setup ist betreibbar”.
Symptome
Das erste Symptom war nicht “alles ist tot”.
Das erste Symptom war eher dieses unangenehme Zwischengefühl:
Irgendwas passt nicht.Typisch für solche Situationen:
mariadb.service ist active
Port 3306 kann offen sein
lokale Verbindung kann funktionieren
der Node ist aber nicht sauber Synced
Clustergröße passt eventuell nicht
wsrep_ready ist eventuell nicht ON
wsrep_cluster_status ist nicht wie erwartet
Genau deshalb ist ein normaler Service-Check zu wenig.
Ein Galera-Node kann technisch laufen und trotzdem für den Clusterbetrieb nicht brauchbar sein.
Erste Prüfung
Der erste Reflex ist natürlich:
sudo systemctl status mariadbDas ist als Einstieg okay.
Aber für Galera reicht das nicht. Deshalb muss direkt danach der Clusterzustand geprüft werden:
sudo mysql -NBe "
SHOW STATUS WHERE Variable_name IN (
  'wsrep_cluster_status',
  'wsrep_cluster_size',
  'wsrep_local_state_comment',
  'wsrep_ready',
  'wsrep_connected'
);
"
Diese Werte sind für mich die Mindestbasis.
Wichtig sind vor allem:
wsrep_cluster_status
wsrep_cluster_size
wsrep_local_state_comment
wsrep_ready
wsrep_connected
Wenn der Dienst läuft, aber einer dieser Werte nicht passt, ist der Node nicht einfach “okay”.
Dann ist er maximal teilweise zurück.
Warum systemd hier täuscht
systemd beantwortet eine andere Frage.
systemd sagt:
Läuft der Prozess?Galera braucht aber zusätzlich die Frage:
Ist dieser Prozess in einem brauchbaren Clusterzustand?Das sind zwei verschiedene Ebenen.
Beispiel:
mariadb.service active
wsrep_local_state_comment = Joining
Das heißt: MariaDB läuft, aber der Node ist noch nicht sauber synchron.
Oder:
mariadb.service active
wsrep_ready = OFF
Das heißt: Der Prozess lebt, aber der Node ist nicht bereit.
Oder:
mariadb.service active
wsrep_cluster_status = Non-Primary
Dann ist der Zustand kritisch, auch wenn systemd noch freundlich grün anzeigt.
Das ist der Klassiker:
Grün auf Prozessebene, rot auf Betriebsebene.
Wahrscheinliche Ursachen
Ohne vollständige Logs und Timeline sollte man bei einem Incident nicht so tun, als hätte man die eine magische Ursache sicher gefunden.
Aber bei Galera nach Reboot gibt es typische Kandidaten.
Boot-Reihenfolge und Clusterzustand
Galera ist empfindlicher als ein einzelner MariaDB-Server.
Wenn mehrere Nodes neu starten oder ein Node zu früh hochkommt, muss klar sein:
Wer war zuletzt Primary?
Welche Nodes sind erreichbar?
Ist Quorum vorhanden?
Darf der Node joinen?
Braucht er IST oder SST?
Wenn diese Kette nicht sauber ist, kann der Dienst starten, aber der Clusterzustand bleibt falsch oder unvollständig.
Netzwerk zwischen den Nodes
Galera hängt stark an stabiler Kommunikation zwischen den Nodes.
Nach einem Reboot können kleine Dinge reichen:
VPN noch nicht bereit
Firewall-Regeln noch nicht vollständig aktiv
DNS oder Hostname-Auflösung kurzzeitig falsch
Provider-Netz braucht ein paar Sekunden länger
Galera startet vor der internen Route
Das ist besonders tückisch, weil der Dienst danach nicht zwingend komplett fehlschlägt. Er kann in einem Zwischenzustand landen.
Disk- und Ressourcenprobleme
Ein weiterer Klassiker: zu wenig Platz oder zu knappe Ressourcen.
Bei einem Node, der vorher schon einmal Disk-Druck hatte, muss man besonders misstrauisch sein.
Disk-full und Galera sind keine gute Kombination.
Wenn Logs, Binlogs, Datenverzeichnis oder temporäre Dateien keinen Platz mehr haben, entstehen gerne Folgefehler. Dann sieht man später nicht “Disk war voll”, sondern irgendeinen Datenbank- oder Clusterfehler.
Deshalb gehört zur Prüfung immer:
df -h
sudo du -h --max-depth=1 /var/lib/mysql 2>/dev/null | sort -h
sudo journalctl -u mariadb -b --no-pager | tail -n 200
Konfigurationsänderungen
Wenn kurz vor dem Reboot Galera-Konfigurationen geändert wurden, muss man auch das prüfen.
Typische Stellen:
/etc/mysql/mariadb.conf.d/60-galera.cnf
wsrep_cluster_address
wsrep_node_address
wsrep_node_name
wsrep_provider_options
bind-address
Firewall / VPN Interface
Bei Cluster-Konfigurationen reicht ein kleiner Unterschied, und ein Node verhält sich nach dem Neustart anders als vorher.
Was ich nicht machen würde
Ich würde in so einer Situation nicht blind anfangen, Dienste mehrfach neu zu starten.
Also nicht:
sudo systemctl restart mariadb
sudo systemctl restart mariadb
sudo systemctl restart mariadb
Das fühlt sich zwar nach Aktion an, ist aber keine Analyse.
Gerade bei Galera muss man vorher wissen:
Ist der Cluster Primary?
Wie viele Nodes sind gesund?
Welcher Node hat den aktuellsten Zustand?
Gibt es Split-Brain-Risiko?
Braucht der Node IST oder SST?
Ist genug Disk frei?
Ein Restart ohne Zustandsbild kann helfen. Oder er macht es schlimmer.
Sauberer Diagnosepfad
Ich würde den Incident künftig so abarbeiten.
Node prüfen
hostname -f
date -u
uptime
df -h
free -m
ip a
ip route
Warum?
Weil ich zuerst wissen will, ob der Host selbst plausibel aussieht.
MariaDB-Prozess prüfen
sudo systemctl status mariadb --no-pager
sudo journalctl -u mariadb -b --no-pager | tail -n 200
Hier geht es um Startfehler, Crashs, offensichtliche Galera-Meldungen, SST/IST-Hinweise und Permission-/Disk-Probleme.
Galera-Status prüfen
sudo mysql -NBe "
SHOW STATUS WHERE Variable_name IN (
  'wsrep_cluster_status',
  'wsrep_cluster_size',
  'wsrep_local_state_comment',
  'wsrep_ready',
  'wsrep_connected',
  'wsrep_incoming_addresses'
);
"
Diese Ausgabe entscheidet, ob der Node wirklich zurück ist.
Von anderen Nodes gegenprüfen
Auf den anderen Nodes ebenfalls prüfen:
sudo mysql -NBe "
SHOW STATUS WHERE Variable_name IN (
  'wsrep_cluster_status',
  'wsrep_cluster_size',
  'wsrep_local_state_comment',
  'wsrep_ready',
  'wsrep_connected'
);
"
Wichtig ist nicht nur der einzelne Node. Wichtig ist das Gesamtbild.
Wenn zwei Nodes Primary und Synced sind und ein Node hängt, ist das ein anderer Fall als ein Cluster, der insgesamt Non-Primary ist.
Netzwerk prüfen
Zwischen den Nodes prüfen:
ping -c 3 <peer-ip>
nc -vz <peer-ip> 3306
nc -vz <peer-ip> 4567
nc -vz <peer-ip> 4568
nc -vz <peer-ip> 4444
Ports hängen natürlich vom Setup ab, aber die Richtung ist klar: Galera-Kommunikation darf nicht am Netzwerk sterben.
Config prüfen
sudo grep -Ev '^\s*#|^\s*$' /etc/mysql/mariadb.conf.d/60-galera.cnfBesonders interessant:
wsrep_cluster_address
wsrep_node_address
wsrep_node_name
wsrep_sst_method
Der eigentliche Fix
Der technische Fix hängt vom konkreten Zustand ab.
Das ist wichtig.
Es gibt nicht den einen Galera-Reboot-Fix, der immer richtig ist.
Wenn der Node nur noch im Übergang hängt, kann ein sauberer Restart mit korrektem Netzwerk reichen.
Wenn ein Node IST/SST braucht, muss man sicherstellen, dass Donor, Ports, Disk und Rechte passen.
Wenn der Cluster Non-Primary ist, muss man deutlich vorsichtiger sein.
Wenn mehrere Nodes gleichzeitig betroffen sind, muss man klären, welcher Node den besten beziehungsweise aktuellsten Zustand hat.
Was ich aber als Fix im weiteren Sinne sehe:
Der Check muss verhindern, dass ein laufender MariaDB-Prozess als gesunder Galera-Node verkauft wird.
Das ist der eigentliche Punkt.
Monitoring-Anpassung
Aus diesem Incident folgt für mich direkt eine Monitoring-Regel.
Nicht nur:
mariadb.service activeSondern:
wsrep_cluster_status = Primary
wsrep_ready = ON
wsrep_connected = ON
wsrep_local_state_comment = Synced
wsrep_cluster_size >= erwarteter Mindestwert
Wenn einer dieser Werte nicht passt, darf das nicht grün sein.
Ein mögliches Ampelmodell:
OK:
- Primary
- Synced
- ready ON
- connected ON
- Clustergröße vollständig

WARNING:
- Clustergröße reduziert, aber Primary und Synced
- Node in kurzfristigem Übergangszustand direkt nach Restart

CRITICAL:
- Non-Primary
- wsrep_ready OFF
- wsrep_connected OFF
- Node länger nicht Synced
- Clustergröße unter Mindestquorum
Wichtig ist “länger”.
Ein Node darf direkt nach einem Restart kurz joinen. Aber er darf nicht unbemerkt dort hängen bleiben.
Was ich daraus gelernt habe
Die Lehre ist nicht neu, aber sie ist wieder einmal bestätigt:
Ein Dienststatus ist kein Betriebszustand.Gerade bei Clustern muss man mehrere Ebenen prüfen.
Für mich sind das:
Host
Prozess
Port
lokale Datenbank
Clusterzustand
Rolle
Readiness
Monitoring
Failover-Tauglichkeit
Erst danach kann man sagen, ob ein Node wirklich wieder da ist.
Nicht nach systemctl.
Was ich in Scripts ändern würde
Ein vorhandenes Cluster-Check-Script sollte nicht nur hübsch Werte ausgeben, sondern klare Exit-Logik haben.
Beispiel:
Exit 0:
Cluster gesund

Exit 1:
Warnung, reduzierter oder Übergangszustand

Exit 2:
Kritisch, Node oder Cluster nicht brauchbar

Exit 3:
Unknown, Check konnte nicht sauber ausgeführt werden
Und es sollte im Output klar sagen:
Was wurde erwartet?
Was wurde gefunden?
Welche Werte sind kritisch?
Welche nächste Aktion ist sinnvoll?
Nicht nur:
ERRORSondern eher:
CRITICAL: wsrep_local_state_comment=Joining, expected Synced.
Node must not be used as failover target.
Check journalctl -u mariadb and peer connectivity.
Das ist im Incident viel hilfreicher.
Prävention
Für künftige Reboots würde ich ein kleines Runbook bauen.
Vor dem Reboot
sudo mysql -NBe "
SHOW STATUS WHERE Variable_name IN (
  'wsrep_cluster_status',
  'wsrep_cluster_size',
  'wsrep_local_state_comment',
  'wsrep_ready',
  'wsrep_connected'
);
"

df -h
Wenn der Cluster vorher schon nicht sauber ist, macht ein Reboot die Situation selten besser.
Reboot durchführen
sudo rebootNach dem Reboot
sudo systemctl status mariadb --no-pager

sudo mysql -NBe "
SHOW STATUS WHERE Variable_name IN (
  'wsrep_cluster_status',
  'wsrep_cluster_size',
  'wsrep_local_state_comment',
  'wsrep_ready',
  'wsrep_connected'
);
"
Nachlauf beobachten
sudo journalctl -u mariadb -fUnd erst wenn der Node wirklich Synced ist, gilt er wieder als sauber zurück.
Status dieser Incident-Notiz
Incident-Typ:
Galera-Node nach Reboot nicht sauber zurück im erwarteten Clusterzustand

Sicher beobachtet:
mariadb.service kann aktiv sein, obwohl der Clusterzustand separat geprüft werden muss

Wahrscheinliche Fehlerklassen:
Boot-Reihenfolge, Netzwerk/VPN/Firewall, Galera Join/SST/IST, Disk/Resource Pressure, Konfigurationsabweichung

Nicht behauptet:
Eine einzige finale Root Cause ohne vollständige Logs

Konsequenz:
Monitoring und Check-Scripts müssen Galera-Zustand fachlich bewerten
Fazit
Dieser Incident ist genau die Sorte Fehler, die ich für XpressLabs dokumentieren will.
Nicht spektakulär.
Nicht dramatisch.
Nicht “alles brennt”.
Sondern realistisch.
Ein Node rebootet.
MariaDB startet.
systemd ist zufrieden.
Aber Galera ist noch nicht dort, wo es sein muss.
Und genau dann entscheidet sich, ob man nur Dienste installiert hat oder ob man sein Setup wirklich betreibt.
Für mich ist die wichtigste Regel nach diesem Fall:
Ein Galera-Node ist erst dann zurück, wenn Galera das sagt — nicht wenn systemd grün ist.
Das klingt banal.
Aber genau solche banalen Sätze retten einem später Zeit.