
Galera, Monitoring, DNS und Security: Warum Infrastruktur nie nur aus einem Dienst besteht
Ein VPS ist schnell bestellt. Spannend wird es erst, wenn Datenbank, Monitoring, DNS und Security zusammenspielen müssen. Genau dort entscheidet sich, ob ein Setup nur läuft oder wirklich betreibbar ist.
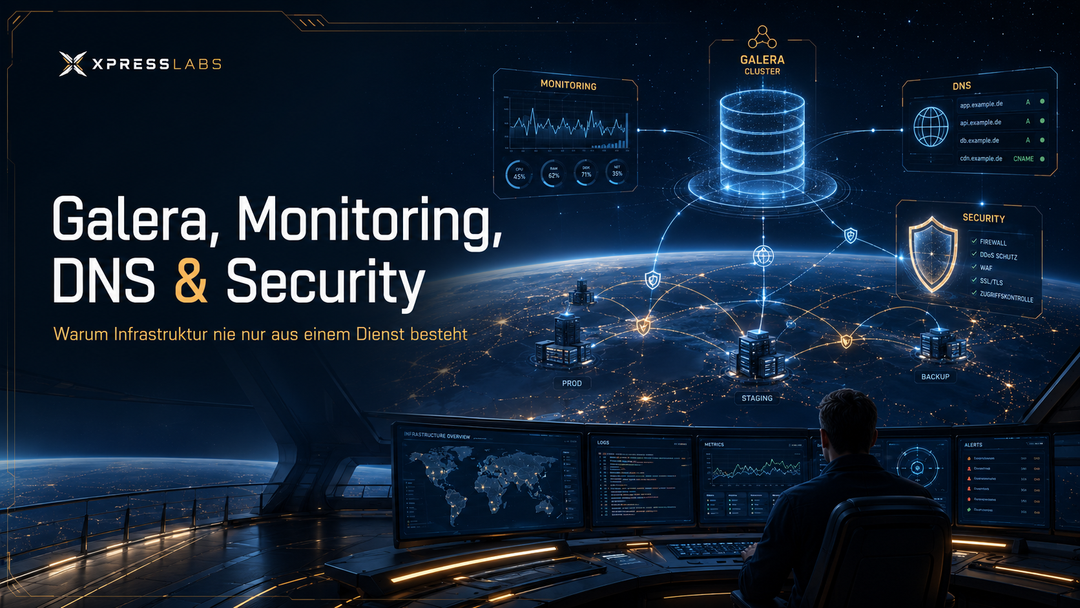
Ein VPS ist schnell bestellt.
Debian drauf, SSH absichern, Apache installieren, MariaDB dazu, DNS setzen, Zertifikat holen und irgendwo noch Monitoring anklemmen. Fertig ist das Setup. Zumindest sieht es am Anfang so aus.
Das Problem beginnt genau dann, wenn man nicht mehr nur fragt:
Läuft der Dienst?
Sondern:
Läuft der Dienst in dem Zustand, in dem ich ihn wirklich brauche?
Und das ist ein völlig anderer Satz.
Eine Datenbank kann gestartet sein und trotzdem nicht sauber im Cluster hängen.
Ein Monitoring kann grün sein und trotzdem den eigentlichen Fehler nicht sehen.
DNS kann korrekt auflösen und trotzdem im Failover genau auf den falschen Node zeigen.
Eine Firewall kann hart sein und trotzdem den Betrieb sabotieren, weil sie interne Health Checks oder Cluster-Kommunikation trifft.
Genau deshalb wollte ich diesen Deep Dive schreiben.
Nicht als theoretische Architekturfolie. Nicht als “Best Practices für High Availability”-Artikel, den man nach drei Absätzen wieder vergisst. Sondern als längere Notiz aus meinem eigenen Setup: Galera, Monitoring, DNS und Security müssen zusammen gedacht werden, sonst baut man sich nur mehrere einzelne Baustellen, die im Fehlerfall nicht miteinander reden.
Der Kern ist für mich inzwischen ziemlich einfach:
Infrastruktur besteht nicht aus installierten Diensten, sondern aus überprüfbaren Zuständen.
Inhaltsverzeichnis
Dieser Beitrag ist bewusst lang geworden. Deshalb hier die Sprungmarken, damit man nicht wie in einem endlosen Logfile suchen muss.
- Warum dieser Deep Dive?
- Ausgangslage: Drei Nodes, viele Rollen, noch mehr Abhängigkeiten
- Galera: Läuft die Datenbank oder ist sie nur gestartet?
- Monitoring: Nicht alles, was grün ist, ist gesund
- DNS: Der unsichtbare Teil vom Failover
- Security: Härtung darf den Betrieb nicht blind machen
- Die eigentliche Klammer: Zustände statt Dienste
- Was ich daraus für mein Setup ableite
- Ein Beispiel: Der gefährliche grüne Zustand
- Warum das Thema nicht nur Homelab ist
- Die drei Fehlerklassen, die ich im Kopf behalten will
- Incident-Szenarien: Was im echten Betrieb passieren kann
- Monitoring als Entscheidungsmaschine
- Was ich bewusst nicht automatisieren würde
- Dokumentation als Kontrollinstrument
- Der eigentliche Zielzustand
- Was hier noch fehlt
- Mein aktueller Zwischenstand
- Fazit
- Technische Anker / Quellen
- Anhang: Meine praktische Checkliste für solche Setups
- Kleine persönliche Wahrheit zum Schluss
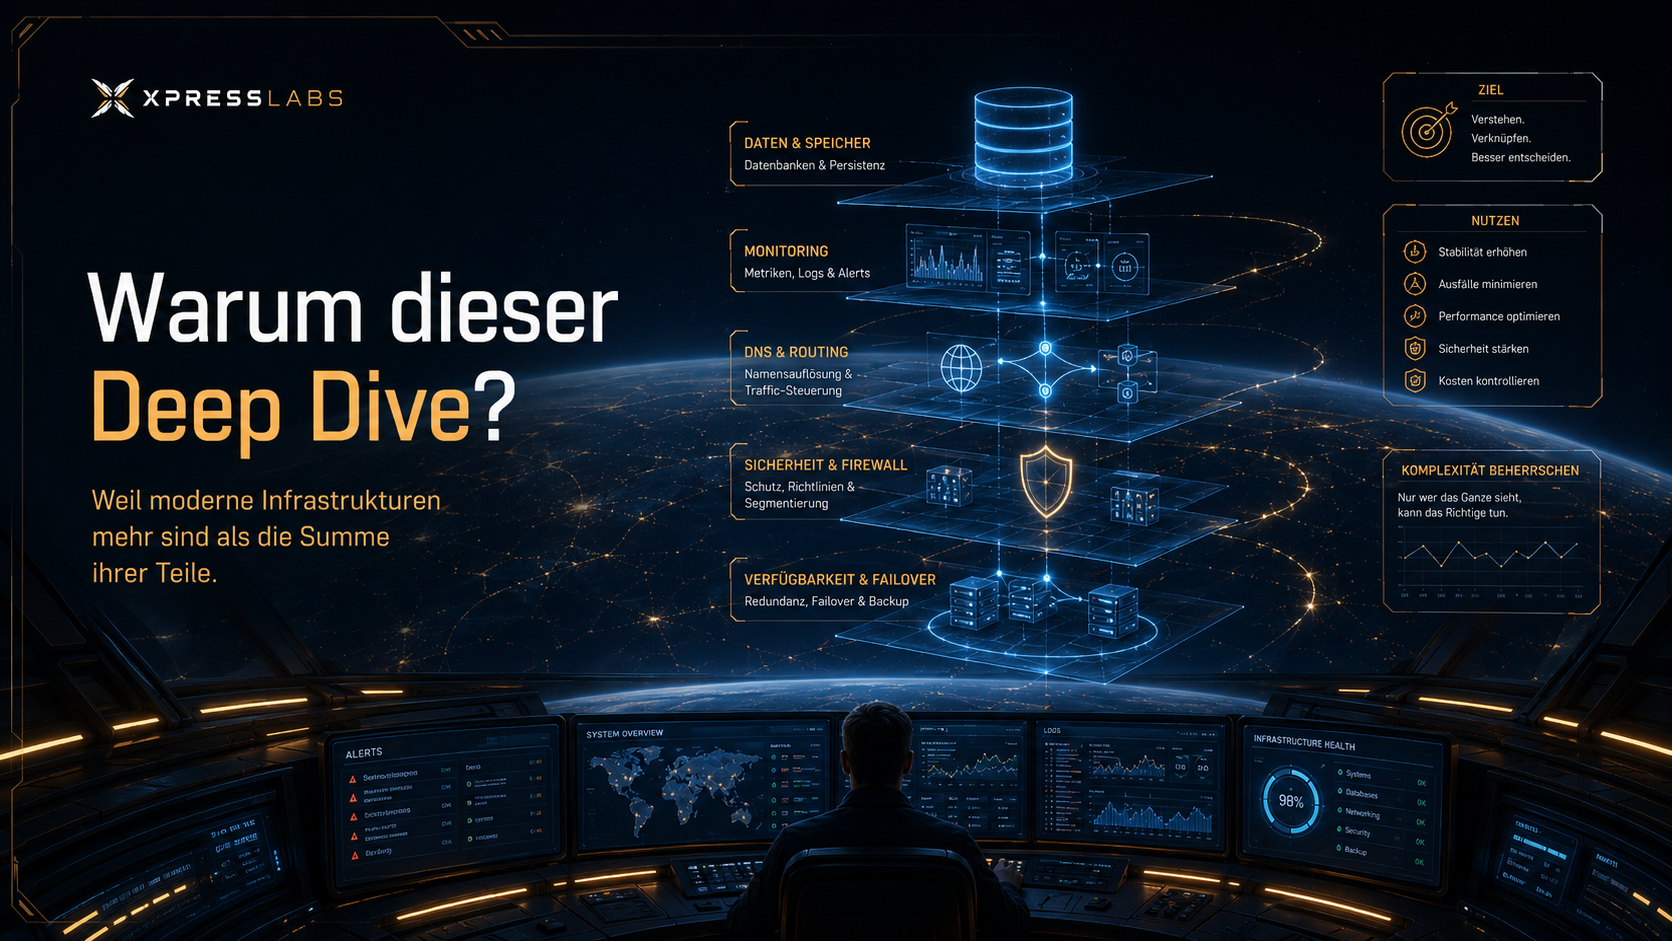
Warum dieser Deep Dive?
Ich habe in den letzten Monaten wieder sehr deutlich gemerkt, wie schnell aus “ich richte mal eben einen Dienst ein” ein echtes Betriebsmodell wird.
Am Anfang ist alles noch angenehm überschaubar.
Ein Node.
Ein Webserver.
Eine Datenbank.
Ein paar DNS-Records.
Ein Zertifikat.
Fertig.
Dann kommt der zweite Node dazu.
Dann der dritte als Witness oder Backup-Ziel.
Dann Dateisynchronisierung.
Dann Galera.
Dann Monitoring.
Dann Failover.
Dann Reverse Proxies.
Dann Digest Auth, OAuth, Zertifikate, Firewall-Zonen, VPN, Backups und Health Checks.
Und plötzlich merkt man:
Ich baue gar nicht mehr nur einzelne Dienste.
Ich baue Annahmen.
Die Annahme, dass ein Node verfügbar ist.
Die Annahme, dass DNS auf den richtigen Node zeigt.
Die Annahme, dass Galera Primary ist.
Die Annahme, dass ein Backup nicht nur existiert, sondern wiederherstellbar ist.
Die Annahme, dass ein Monitoring-OK wirklich OK bedeutet.
Die Annahme, dass Security schützt und nicht blind macht.
Das klingt erst einmal etwas philosophisch, ist aber im Betrieb sehr konkret.
Wenn ich ein Shellscript schreibe, das bei einem Fehler den Cloudflare-DNS-Record auf den zweiten Node umbiegt, dann steckt darin eine ganze Kette von Annahmen:
Der erste Node ist wirklich kaputt.
Der zweite Node ist wirklich bereit.
Die Datenbank auf dem zweiten Node ist brauchbar.
Die Dateien sind synchron genug.
Apache antwortet korrekt.
Das Zertifikat passt.
Die Firewall lässt den Traffic durch.
Das Monitoring wird den Wechsel erkennen.
DNS wird schnell genug sichtbar.
Wenn nur eine dieser Annahmen falsch ist, kann ein automatisches Failover aus einem Ausfall einen größeren Ausfall machen.
Das ist der Punkt, an dem Infrastruktur spannend wird. Nicht bei der Installation. Installation ist oft nur Fleißarbeit. Spannend wird es bei den Übergängen, Zuständen und Fehlerfällen.
Und genau dort fangen viele 0815-Artikel an zu schwimmen. Da steht dann “installiere Galera”, “richte Monitoring ein”, “nutze Cloudflare API” und “härte SSH”. Alles richtig. Aber die eigentliche Frage bleibt offen:
Wie erkenne ich, ob das System als Ganzes noch in einem brauchbaren Zustand ist?
Dieser Artikel ist mein Versuch, genau diese Frage einmal sauber auseinanderzunehmen.
Nicht final. Nicht perfekt. Aber deutlich tiefer als ein kurzer Setup-Post.
Ausgangslage: Drei Nodes, viele Rollen, noch mehr Abhängigkeiten
Mein Setup ist bewusst nicht riesig, aber auch nicht mehr trivial.
Es gibt mehrere VPS-Nodes mit unterschiedlichen Rollen. Ein primärer Node, ein sekundärer Node und ein dritter Node für Witness-, Backup- und Monitoring-Themen. Dazu kommen öffentlich erreichbare Dienste, interne VPN-Kommunikation, Cloudflare DNS, Apache Reverse Proxy, MariaDB/Galera, Dateisynchronisierung, Backups und Monitoring.
Das ist kein Enterprise-Rechenzentrum.
Aber genau das macht es interessant.
In einem großen Enterprise-Setup kann man vieles organisatorisch erschlagen: Teams, Prozesse, Tools, Tickets, CMDB, Load Balancer, Firewall-Teams, Datenbank-Teams, Security-Teams. Ob das dann besser funktioniert, ist eine andere Frage, aber zumindest gibt es Rollen.
In einem privaten oder kleinen Setup ist man selbst alles gleichzeitig:
Architekt
Admin
DBA
Security
Monitoring
Incident Response
Dokumentation
Change Manager
der Typ, der nachts den Fehler findet
Das ist Fluch und Vorteil zugleich.
Der Vorteil: Man kann Zusammenhänge sehen.
Der Nachteil: Man kann sich auch sehr schnell selbst belügen.
Zum Beispiel mit einem grünen Monitoring-Dashboard.
Wenn dort alles grün ist, fühlt sich das gut an. Nur sagt ein grünes Dashboard nicht automatisch, dass alles gesund ist. Es sagt erst einmal nur, dass die Checks, die man gebaut hat, grün sind.
Und genau da wird es gefährlich.
Wenn ich nur prüfe, ob mariadb.service läuft, dann bekomme ich ein anderes Bild, als wenn ich prüfe, ob Galera Primary ist, der Node Synced ist, wsrep_ready auf ON steht und der Cluster die erwartete Größe hat.
Wenn ich nur prüfe, ob HTTP 200 kommt, dann bekomme ich ein anderes Bild, als wenn ich zusätzlich prüfe, ob der Content vom aktiven Node kommt, ob die Datenbank schreibt, ob die Session funktioniert und ob DNS auf den richtigen Host zeigt.
Wenn ich nur prüfe, ob der Server pingbar ist, dann weiß ich noch lange nicht, ob er eine Rolle im Setup sinnvoll erfüllen kann.
Das ist für mich der Kern dieses Artikels:
Ein Dienst kann technisch laufen und betrieblich trotzdem unbrauchbar sein.
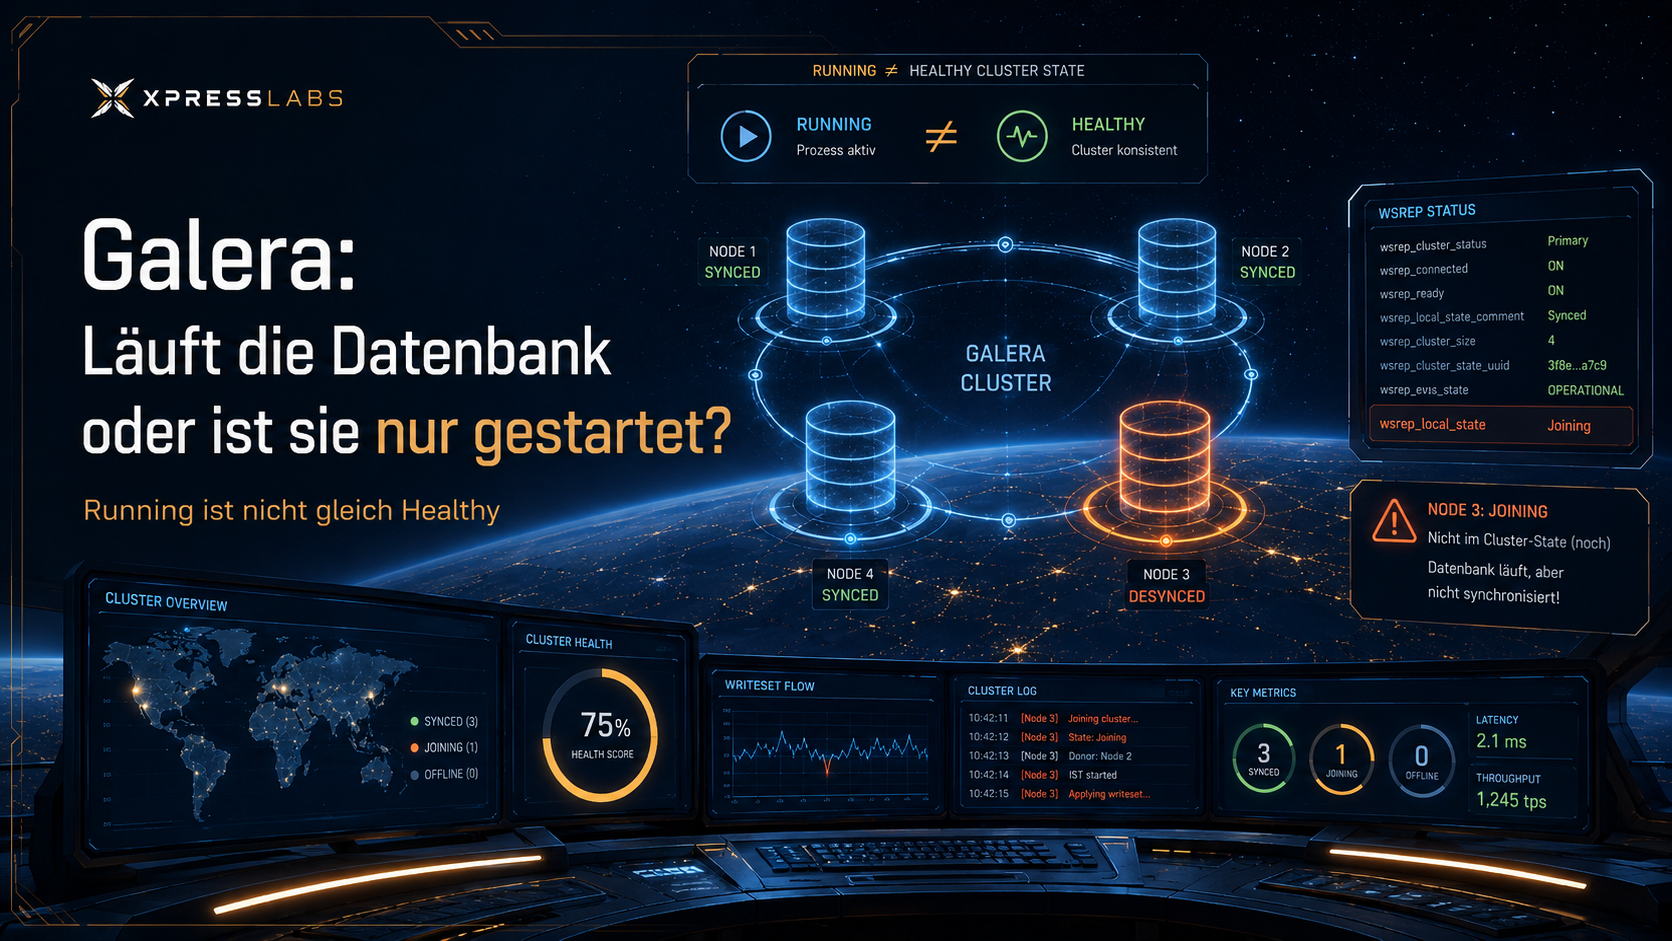
Galera: Läuft die Datenbank oder ist sie nur gestartet?
MariaDB Galera ist ein schönes Beispiel, weil Galera einen sehr unangenehmen Unterschied sichtbar macht:
mariadb.service active
ist nicht dasselbe wie:
Cluster gesund
Das ist ein Satz, den man eigentlich direkt über jedes Galera-Setup schreiben müsste.
Ein einzelner MariaDB-Prozess kann sauber laufen. systemd ist zufrieden. Der Port ist offen. Vielleicht kann man sogar lokal verbinden. Und trotzdem ist der Node nicht wirklich dort, wo man ihn im Cluster haben will.
Bei Galera interessiert mich deshalb nicht nur der Prozess, sondern mindestens:
SHOW STATUS LIKE 'wsrep_cluster_size';
SHOW STATUS LIKE 'wsrep_cluster_status';
SHOW STATUS LIKE 'wsrep_local_state_comment';
SHOW STATUS LIKE 'wsrep_ready';
SHOW STATUS LIKE 'wsrep_connected';
Das sind keine akademischen Werte.
Diese Werte entscheiden darüber, ob ein Node aus Cluster-Sicht brauchbar ist.
Ein paar Beispiele:
wsrep_cluster_status = Primary
Das ist wichtig, weil ein Cluster ohne Primary-Komponente nicht einfach normal weiterarbeiten soll. Wenn der Cluster kein Quorum beziehungsweise keine Primary-Komponente mehr hat, ist das kein kleines Detail, sondern ein massiver Betriebszustand.
wsrep_local_state_comment = Synced
Das ist für mich einer der wichtigsten Werte auf Node-Ebene. Ein Node kann gestartet sein, aber noch Joining, Donor, Joined oder in irgendeinem Übergangszustand hängen. Für den Normalbetrieb will ich aber Synced sehen.
wsrep_ready = ON
Wenn der Node nicht ready ist, ist er nicht bereit, Queries sauber anzunehmen. Punkt.
wsrep_connected = ON
Wenn das nicht stimmt, ist der Node aus Cluster-Sicht isoliert oder nicht verbunden. Auch dann hilft mir ein laufender Prozess alleine nicht.
Und dann kommt noch:
wsrep_cluster_size
Wenn ich drei Nodes erwarte und nur einer oder zwei gesehen werden, muss ich das wissen. Nicht irgendwann. Nicht nach dem nächsten Datenbankfehler. Sondern sofort.
Der typische Fehler nach einem Reboot
Ein sehr realistisches Problem ist der Reboot.
Man fährt einen Node runter. Oder ein Provider rebootet. Oder man macht Wartung. Danach kommt der Dienst wieder hoch. systemd sagt “active”. Man atmet kurz auf.
Aber Galera ist eben nicht automatisch gesund, nur weil MariaDB wieder gestartet ist.
Der Node muss sauber in den Cluster zurück. Je nach Zustand, Netzwerk, Reihenfolge, grastate.dat, Cluster-Kommunikation, SST/IST und Konfiguration kann das sauber funktionieren oder eben nicht.
Und genau hier braucht man saubere Checks.
Ich möchte nach einem Reboot nicht nur sehen:
sudo systemctl status mariadb
Sondern eher:
sudo mysql -e "SHOW STATUS LIKE 'wsrep_cluster_status';"
sudo mysql -e "SHOW STATUS LIKE 'wsrep_cluster_size';"
sudo mysql -e "SHOW STATUS LIKE 'wsrep_local_state_comment';"
sudo mysql -e "SHOW STATUS LIKE 'wsrep_ready';"
sudo mysql -e "SHOW STATUS LIKE 'wsrep_connected';"
Oder als kompakten Check:
sudo mysql -NBe "
SHOW STATUS WHERE Variable_name IN (
  'wsrep_cluster_status',
  'wsrep_cluster_size',
  'wsrep_local_state_comment',
  'wsrep_ready',
  'wsrep_connected'
);
"
Wenn ich daraus ein Monitoring ableite, dann ist die Logik relativ klar:
CRITICAL, wenn wsrep_cluster_status != Primary
CRITICAL, wenn wsrep_ready != ON
CRITICAL, wenn wsrep_connected != ON
CRITICAL, wenn wsrep_local_state_comment != Synced
WARNING oder CRITICAL, wenn wsrep_cluster_size kleiner als erwartet ist
Ob Cluster Size sofort CRITICAL ist, hängt vom Setup ab. Wenn ein dreier Cluster bewusst mit zwei Nodes weiterläuft, kann das WARNING sein. Wenn zwei Nodes aber schon kritisch sind, muss das in die Betriebslogik.
Das ist kein Detail, das man einfach einem generischen Check überlassen sollte.
Warum systemctl trotzdem nicht wertlos ist
Natürlich ist systemctl status mariadb nicht sinnlos.
Es ist nur die falsche Ebene, wenn man damit den Clusterzustand erklären will.
Ich brauche mehrere Ebenen:
Prozess läuft?
Port offen?
Datenbank nimmt lokale Queries an?
Galera verbunden?
Cluster Primary?
Node Synced?
Erwartete Clustergröße?
Schreib-/Leseverhalten plausibel?
Erst wenn diese Ebenen zusammenpassen, entsteht ein brauchbares Bild.
Das gilt nicht nur für Galera. Das gilt eigentlich für jeden Dienst, der Teil eines größeren Systems ist.
Ein Nginx kann laufen und trotzdem falsch routen.
Ein Apache kann HTTP 200 liefern und trotzdem die falsche vHost-Konfiguration nutzen.
Ein Redis kann laufen und trotzdem nicht von der Anwendung verwendet werden.
Ein Backup kann erfolgreich beendet sein und trotzdem nie getestet worden sein.
Laufen ist der Anfang. Nicht das Ziel.
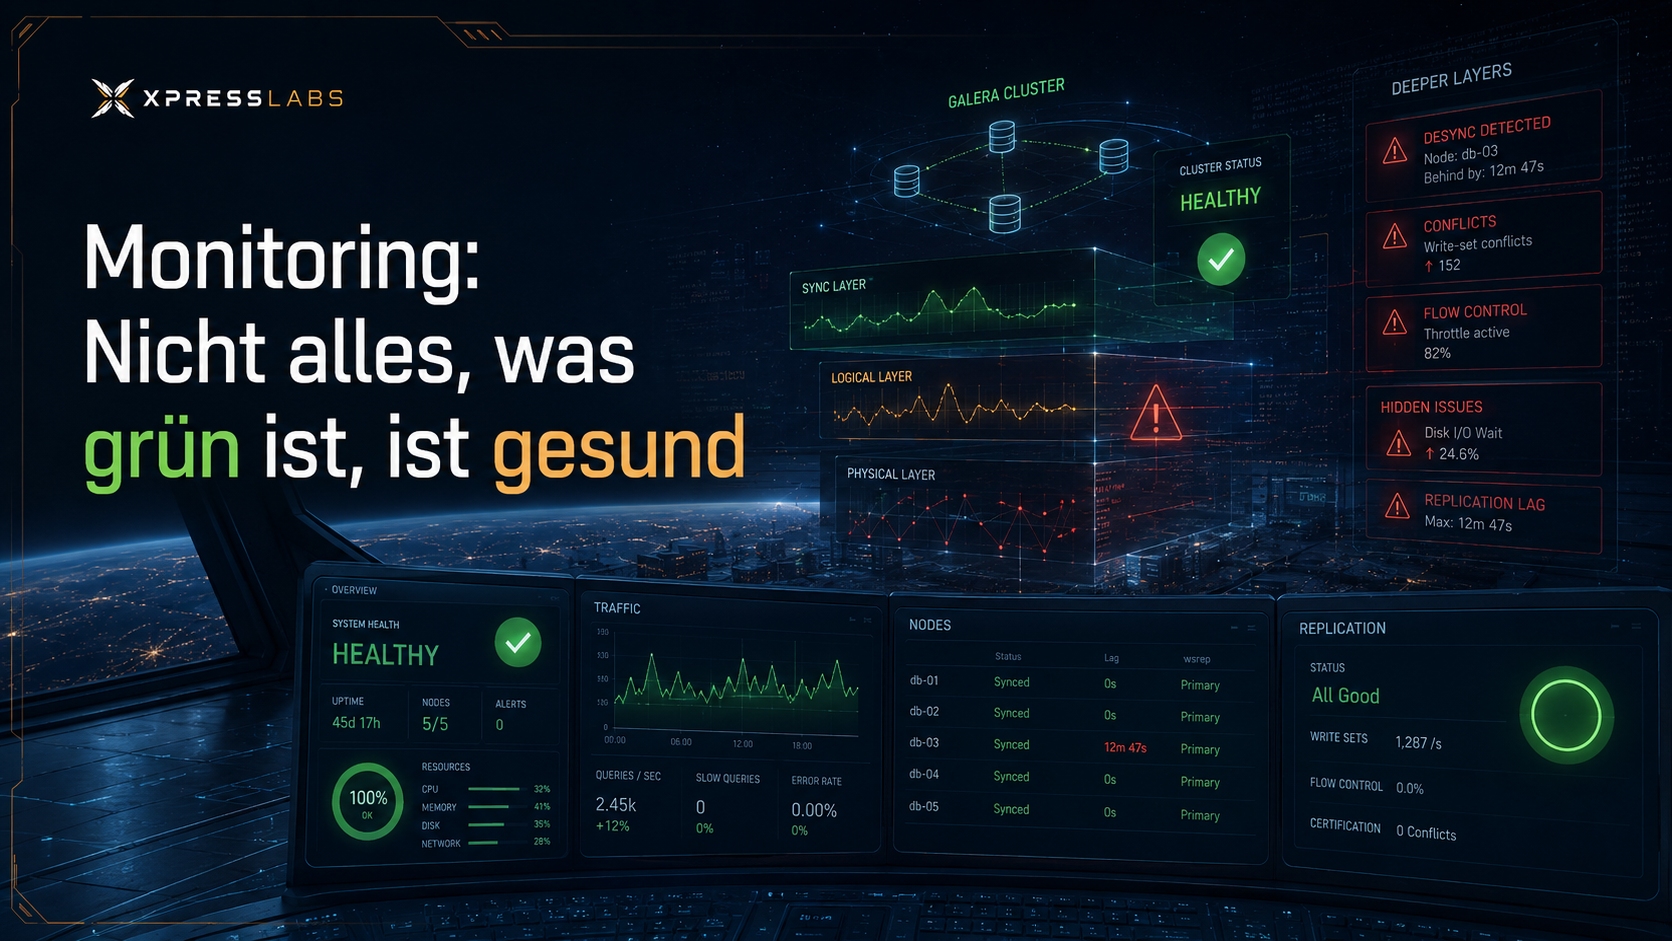
Monitoring: Nicht alles, was grün ist, ist gesund
Monitoring ist das Thema, bei dem man sich am leichtesten selbst betrügt.
Ein grünes Dashboard beruhigt.
Ein grünes Dashboard sieht professionell aus.
Ein grünes Dashboard fühlt sich nach Kontrolle an.
Aber ein grünes Dashboard ist nur so gut wie die Fragen, die es stellt.
Wenn die falschen Fragen gestellt werden, ist grün gefährlich.
Das klingt hart, aber genau so ist es.
Ein klassischer erster Monitoring-Ansatz sieht oft so aus:
Host pingbar?
SSH offen?
HTTP erreichbar?
MariaDB läuft?
Disk nicht voll?
CPU okay?
RAM okay?
Das ist gut. Wirklich. Besser als nichts. Und für viele kleine Setups ist das der erste sinnvolle Schritt.
Aber für ein Cluster-Setup reicht es nicht.
Denn ein Host kann pingbar sein und trotzdem betrieblich kaputt.
HTTP kann 200 liefern und trotzdem aus einem Cache kommen.
MariaDB kann laufen und trotzdem nicht im Cluster sein.
Disk kann noch 10 Prozent frei haben und trotzdem gehen Binlogs oder Backups gleich auf die Nase.
CPU kann okay sein und trotzdem hängt Galera wegen Flow Control oder Netzwerkproblemen.
Monitoring muss Betriebsannahmen abbilden
Für mich ist ein guter Check nicht einfach eine technische Messung. Ein guter Check überprüft eine Betriebsannahme.
Beispiele:
Annahme: Der Webservice ist für Nutzer erreichbar.
Check: HTTP GET auf öffentliche URL, erwarteter Statuscode, erwarteter Inhalt, TLS gültig.

Annahme: Der Galera-Node ist als Cluster-Node brauchbar.
Check: wsrep_cluster_status=Primary, wsrep_ready=ON, wsrep_local_state_comment=Synced.

Annahme: DNS zeigt auf den aktiven Node.
Check: DNS-Auflösung gegen mehrere Resolver plus Vergleich mit erwarteter IP.

Annahme: Backups sind verwertbar.
Check: Letzter Lauf erfolgreich, Repository erreichbar, letzte Archivliste plausibel, Restore-Test regelmäßig geplant.

Annahme: Security blockiert nicht den internen Betrieb.
Check: VPN erreichbar, Cluster-Ports zwischen Nodes offen, Monitoring-Pfade erlaubt, Public-Zugriffe limitiert.
Das ist ein anderes Denken.
Nicht:
Welche Ports sind offen?
Sondern:
Welche Aussage möchte ich über mein System treffen?
Und dann baut man den Check dazu.
Active Checks, Passive Checks und echte End-to-End-Sicht
Ich mag bei Monitoring die Unterscheidung zwischen interner Sicht und externer Sicht.
Interne Sicht:
Was sagt der Agent auf dem Host?
Was sagt systemd?
Was sagen lokale Metriken?
Was sagt die Datenbank intern?
Externe Sicht:
Kann ein Nutzer die Seite erreichen?
Stimmt TLS?
Antwortet die richtige URL?
Löst DNS korrekt auf?
Ist der Dienst aus einem anderen Netz erreichbar?
Beides ist wichtig.
Wenn die interne Sicht grün ist, aber extern nichts geht, interessiert den Nutzer die interne Sicht nicht. Wenn extern HTTP 200 kommt, intern aber Galera gerade auseinanderläuft, merkt der Nutzer vielleicht erst später etwas, aber der Fehler ist trotzdem da.
Das ist auch der Grund, warum ich Checks nicht nur “schön im Dashboard” haben will, sondern als Entscheidungsgrundlage für Failover und Wartung.
Ein Failover-Script darf nicht dieselben blinden Flecken haben wie ein zu oberflächliches Dashboard.
Die grüne Lüge
Mein Lieblingsbeispiel ist der gefährliche grüne Zustand.
Nehmen wir an, ein Dashboard sagt:
Host: OK
MariaDB: OK
HTTP: OK
Disk: OK
CPU: OK
Alles grün.
Darunter liegt aber:
wsrep_local_state_comment = Joining
wsrep_cluster_size = 2 statt 3
wsrep_ready = OFF
Dann ist das Dashboard nicht “fast richtig”.
Es ist falsch.
Oder präziser: Es beantwortet eine andere Frage.
Es beantwortet:
Sind einige technische Einzelwerte okay?
Es beantwortet nicht:
Ist mein Datenbank-Cluster in dem Zustand, den ich brauche?
Das ist der Unterschied, den man im Alltag schnell übersieht.
Und genau deshalb ist Monitoring für mich kein rein technisches Tooling-Thema. Es ist ein Modellierungsproblem.
Man muss modellieren, was gesund bedeutet.
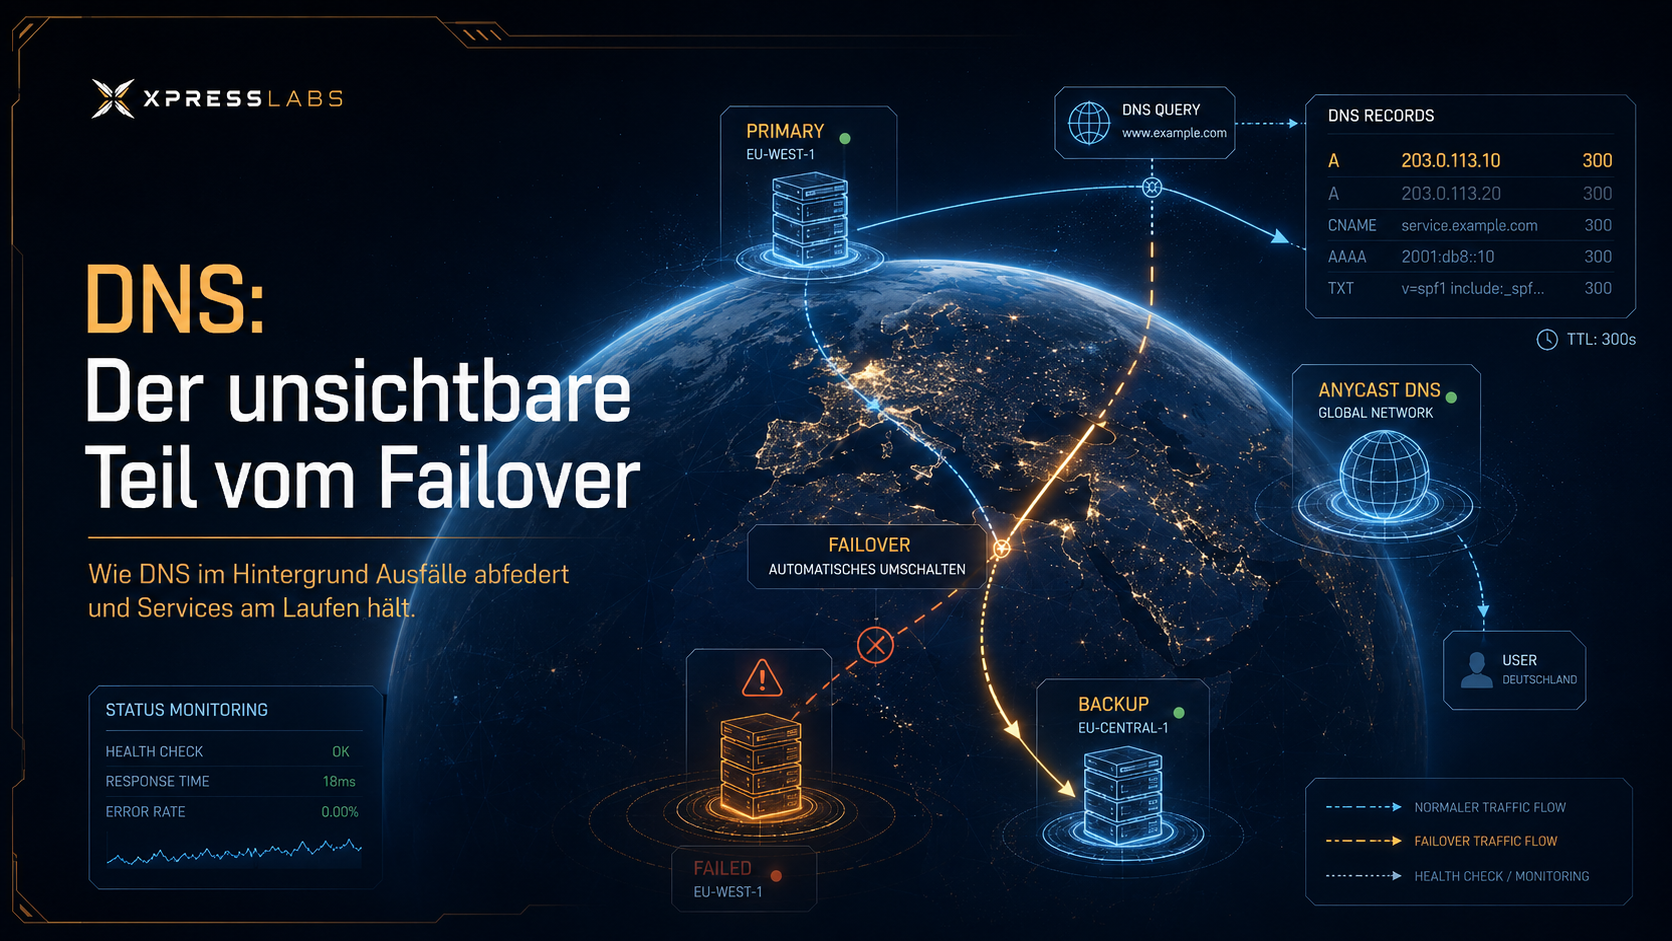
DNS: Der unsichtbare Teil vom Failover
DNS ist meistens langweilig, bis es plötzlich nicht mehr langweilig ist.
Solange eine Domain auf eine IP zeigt und alles läuft, denkt man kaum darüber nach.
Ein A-Record.
Vielleicht AAAA.
Vielleicht CNAME.
TTL setzen.
Fertig.
Aber sobald Failover ins Spiel kommt, wird DNS zu einem aktiven Teil des Betriebsmodells.
Dann geht es nicht mehr nur darum, ob eine Domain auflöst. Dann geht es um die Frage:
Zeigt die Domain auf den Node, der die Rolle gerade wirklich erfüllen kann?
Das ist wieder ein Zustand.
DNS-Failover ist nicht nur ein API-Call
Cloudflare per API umzuschalten ist technisch nicht besonders kompliziert.
Record suchen.
Record patchen.
IP ändern.
Fertig.
Das Problem ist nicht der API-Call.
Das Problem ist die Entscheidung davor.
Wann darf ich umschalten?
Ein naiver Ansatz wäre:
Wenn Node 1 nicht antwortet, setze DNS auf Node 2.
Das klingt logisch. Es ist aber gefährlich.
Besser ist:
Wenn Node 1 über mehrere unabhängige Checks nicht nutzbar ist
und Node 2 über mehrere unabhängige Checks als bereit gilt
und kein Lock / Maintenance-Fenster aktiv ist
und die Datenbankrolle plausibel ist
und Web/Files/Zertifikate passen,
dann darf DNS umgeschaltet werden.
Das ist länger. Aber Infrastruktur ist oft genau das: längere Sätze, die im Fehlerfall verhindern, dass man Unsinn automatisiert.
Was muss vor DNS-Failover geprüft werden?
Für mein Setup würde ich mindestens folgende Punkte prüfen wollen:
1. Ist der bisher aktive Node wirklich gestört?
2. Ist der Ziel-Node erreichbar?
3. Antwortet Apache auf dem Ziel-Node korrekt?
4. Ist der relevante vHost aktiv?
5. Ist TLS gültig?
6. Ist Galera auf dem Ziel-Node in einem brauchbaren Zustand?
7. Sind Dateien plausibel synchron?
8. Ist genug Disk frei?
9. Ist kein Maintenance-Lock aktiv?
10. Wurde der Fehler mehrfach bestätigt?
Das ist nicht Enterprise-Theater. Das ist Selbstschutz.
Denn ein falsches Failover ist nicht besser als ein Ausfall.
Wenn ich DNS auf einen Node umbiege, der zwar erreichbar ist, aber eine kaputte Datenbankrolle hat, habe ich nichts gewonnen. Wenn ich DNS auf einen Node umbiege, der keine aktuellen Dateien hat, habe ich nichts gewonnen. Wenn ich DNS zu schnell hin und her schalte, habe ich mir Flapping gebaut.
TTL und Erwartungsmanagement
DNS ist außerdem nie vollständig sofort.
Selbst wenn Cloudflare schnell aktualisiert, existieren Resolver, Caches, Clients und unterschiedliche Pfade. Bei proxied Records ist die TTL-Situation anders als bei reinem DNS-only. Bei Cloudflare liegt bei proxied Records die TTL typischerweise auf Auto beziehungsweise einem kurzen Wert, aber man sollte daraus trotzdem keine magische Sofortigkeit ableiten.
Praktisch heißt das:
DNS-Failover ist schnell genug für viele private und kleine Setups.
DNS-Failover ist aber kein Load Balancer mit Health Checks im Datenpfad.
Das ist ein wichtiger Unterschied.
Wenn ich harte Hochverfügbarkeit im Sekundenbereich brauche, ist DNS alleine wahrscheinlich das falsche Werkzeug. Wenn ich aber ein privates Setup betreibe, bei dem ein kontrollierter Wechsel innerhalb kurzer Zeit reicht, ist DNS-Failover über Cloudflare pragmatisch.
Aber auch dann gilt:
DNS entscheidet nicht, ob ein Node gesund ist. DNS setzt nur die Entscheidung um.
Die Entscheidung muss vorher aus Monitoring, Health Checks und Rollenlogik kommen.
DNS als Teil der Dokumentation
DNS hat noch einen zweiten Effekt: Es dokumentiert implizit Architektur.
Subdomains erzählen eine Geschichte:
blog.example.tld
mon.example.tld
fs.example.tld
admin.example.tld
checkmk.example.tld
Wenn diese Namen chaotisch wachsen, wird das Setup chaotisch. Wenn Namen Rollen klar ausdrücken, hilft das später enorm.
Ich habe früher DNS oft als Nebenbei-Thema betrachtet. Heute sehe ich DNS eher als öffentliche Oberfläche des Betriebsmodells.
Welche Dienste gibt es?
Welche sind öffentlich?
Welche sind nur intern?
Welche hängen an Reverse Proxy?
Welche dürfen im Failover umziehen?
Welche sind Node-spezifisch?
Das sind keine reinen DNS-Fragen. Das sind Architekturfragen.
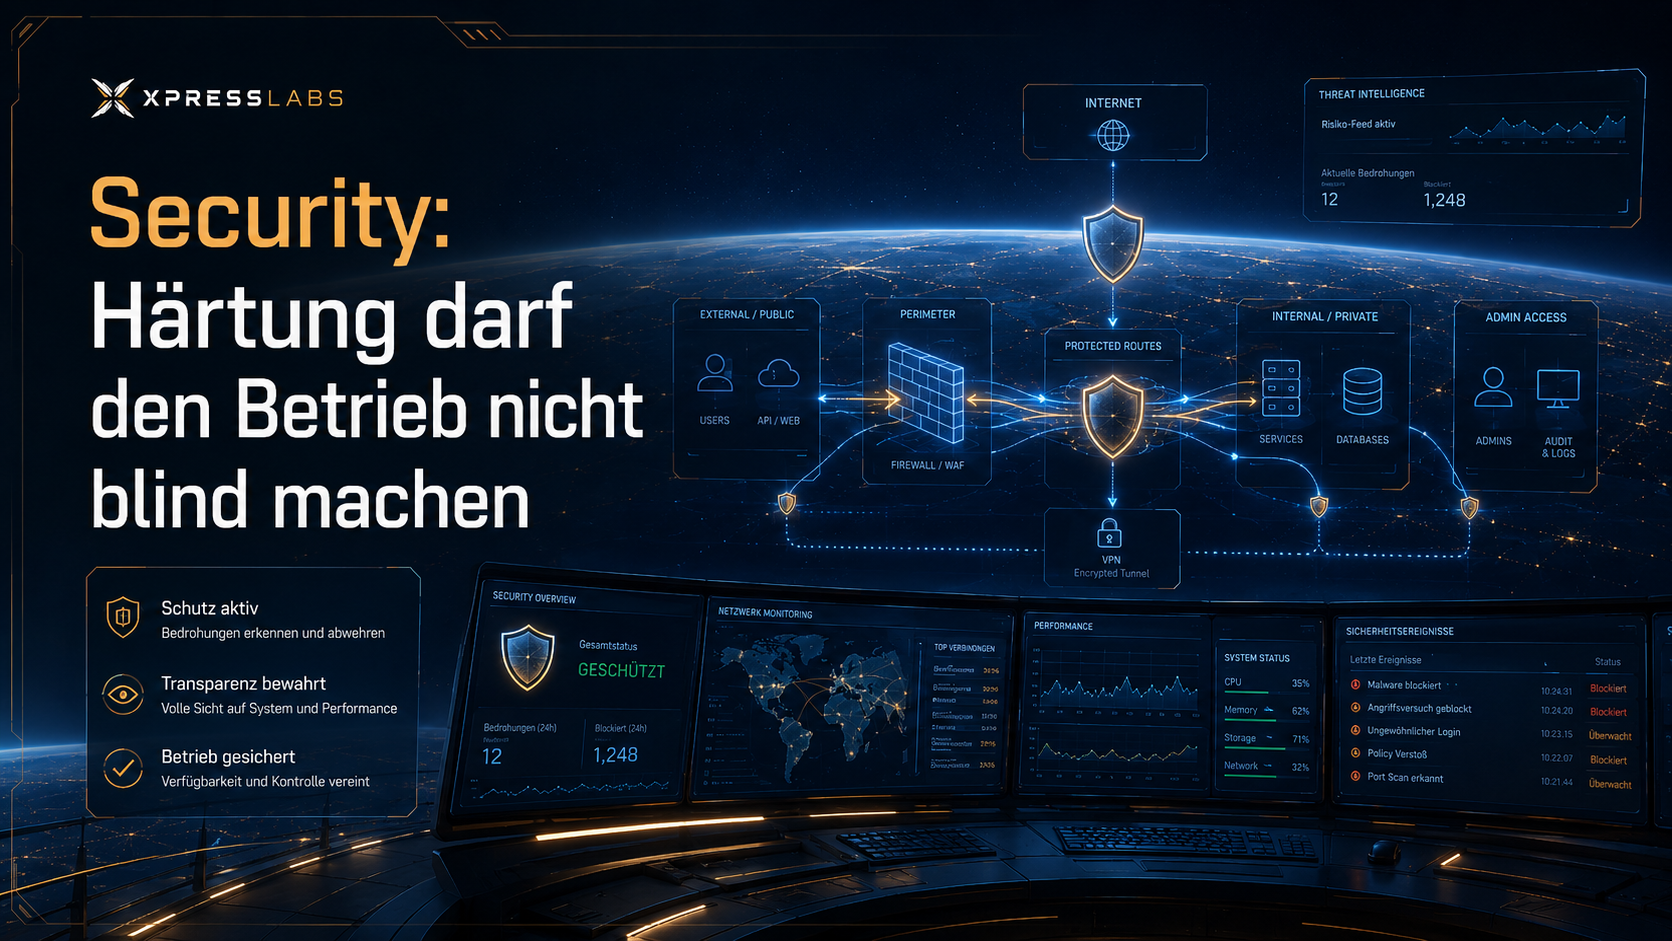
Security: Härtung darf den Betrieb nicht blind machen
Security ist wichtig. Aber Security kann auch nerven. Und schlimmer: Security kann das eigene Setup kaputt machen, wenn sie ohne Betriebsverständnis umgesetzt wird.
Das ist ein Satz, den man nicht gerne hört, aber er stimmt.
Eine Firewall-Regel kann sicher aussehen und trotzdem falsch sein.
Ein Rate Limit kann Angriffe bremsen und gleichzeitig Health Checks treffen.
Eine Auth-Schicht kann schützen und gleichzeitig Monitoring oder Automatisierung aussperren.
Ein VPN kann interne Kommunikation absichern und gleichzeitig zur Single Point of Failure werden, wenn man keine Fallbacks bedenkt.
Security ist nicht einfach “alles zu”.
Security ist:
Das Richtige offen.
Das Falsche zu.
Das Erlaubte sichtbar.
Das Verbotene geloggt.
Das Interne getrennt vom Öffentlichen.
Zonen statt Portlisten
Für mich ist der wichtige Schritt: nicht nur Ports denken, sondern Zonen.
Ein Setup mit mehreren Nodes hat unterschiedliche Traffic-Arten:
Public Web Traffic
Public SSH
VPN Traffic
Cluster Traffic
Monitoring Traffic
Backup Traffic
Admin Traffic
Reverse Proxy Traffic
DNS/API Traffic
Wenn man das alles gleich behandelt, wird es unsauber.
Öffentliches SSH darf sehr hart limitiert sein.
Interner VPN-Traffic sollte nicht durch dieselben Rate Limits fallen.
Galera-Kommunikation gehört nicht ins öffentliche Internet.
Monitoring muss bestimmte Dinge sehen dürfen, aber nicht beliebig viel.
Backups brauchen eigene User, eigene Keys und möglichst eingeschränkte Rechte.
Admin-Zugriff sollte nicht mit normalem Webtraffic vermischt werden.
Das klingt nach viel Trennung. Aber eigentlich ist es nur Ordnung.
Rate Limits und Monitoring
Rate Limits sind ein schönes Beispiel.
Es ist sinnvoll, SSH öffentlich zu begrenzen. Es ist auch sinnvoll, HTTP/HTTPS nicht komplett unlimitiert zu lassen, wenn man einfache Schutzmechanismen bauen möchte.
Aber Rate Limits auf dem falschen Pfad können Monitoring verwirren.
Wenn ein Monitoring-System regelmäßig Checks macht und dabei in Limits läuft, bekommt man irgendwann False Positives. Wenn ein Health-Check-Script während Lastspitzen geblockt wird, kann ein Failover fälschlich starten. Wenn VPN-Traffic limitiert wird wie öffentliches Internet, trifft man genau den Bereich, der eigentlich vertrauenswürdiger und stabiler sein soll.
Also muss Security auch die Frage beantworten:
Welche Checks müssen immer durchkommen?
Nicht weil Monitoring mehr Rechte haben soll als nötig. Sondern weil ein System, das seine eigenen Sensoren blockiert, blind wird.
Authentifizierung und Bedienbarkeit
Ein anderer Punkt: Auth.
Digest Auth, Basic Auth, OAuth2 Proxy, OIDC, Admin-Portale, VPN-only Zugriff — alles kann sinnvoll sein.
Aber jedes zusätzliche Auth-Layer muss zur Nutzung passen.
Wenn Netdata, Checkmk, Syncthing, BorgWeb oder interne Admin-Oberflächen so nervig geschützt sind, dass man sie im Fehlerfall nicht schnell erreicht, ist das auch ein Problem. Wenn man sich alle paar Stunden neu anmelden muss und im Incident erstmal gegen Auth-Dialoge kämpft, hat man Security auf Kosten von Bedienbarkeit gebaut.
Das heißt nicht, dass man Security abschalten soll.
Es heißt nur:
Security muss den Incident-Fall mitdenken.
Kann ich im Fehlerfall noch zugreifen?
Sind Credentials verfügbar?
Funktioniert Auth, wenn ein Node weg ist?
Hängt Auth selbst an dem System, das gerade Probleme hat?
Gibt es Break-Glass-Zugriff?
Ist der Zugriff geloggt?
Gerade bei kleinen Setups muss man da pragmatisch bleiben.
Perfekte Security, die man im Ernstfall nicht bedienen kann, ist auch kein Gewinn.
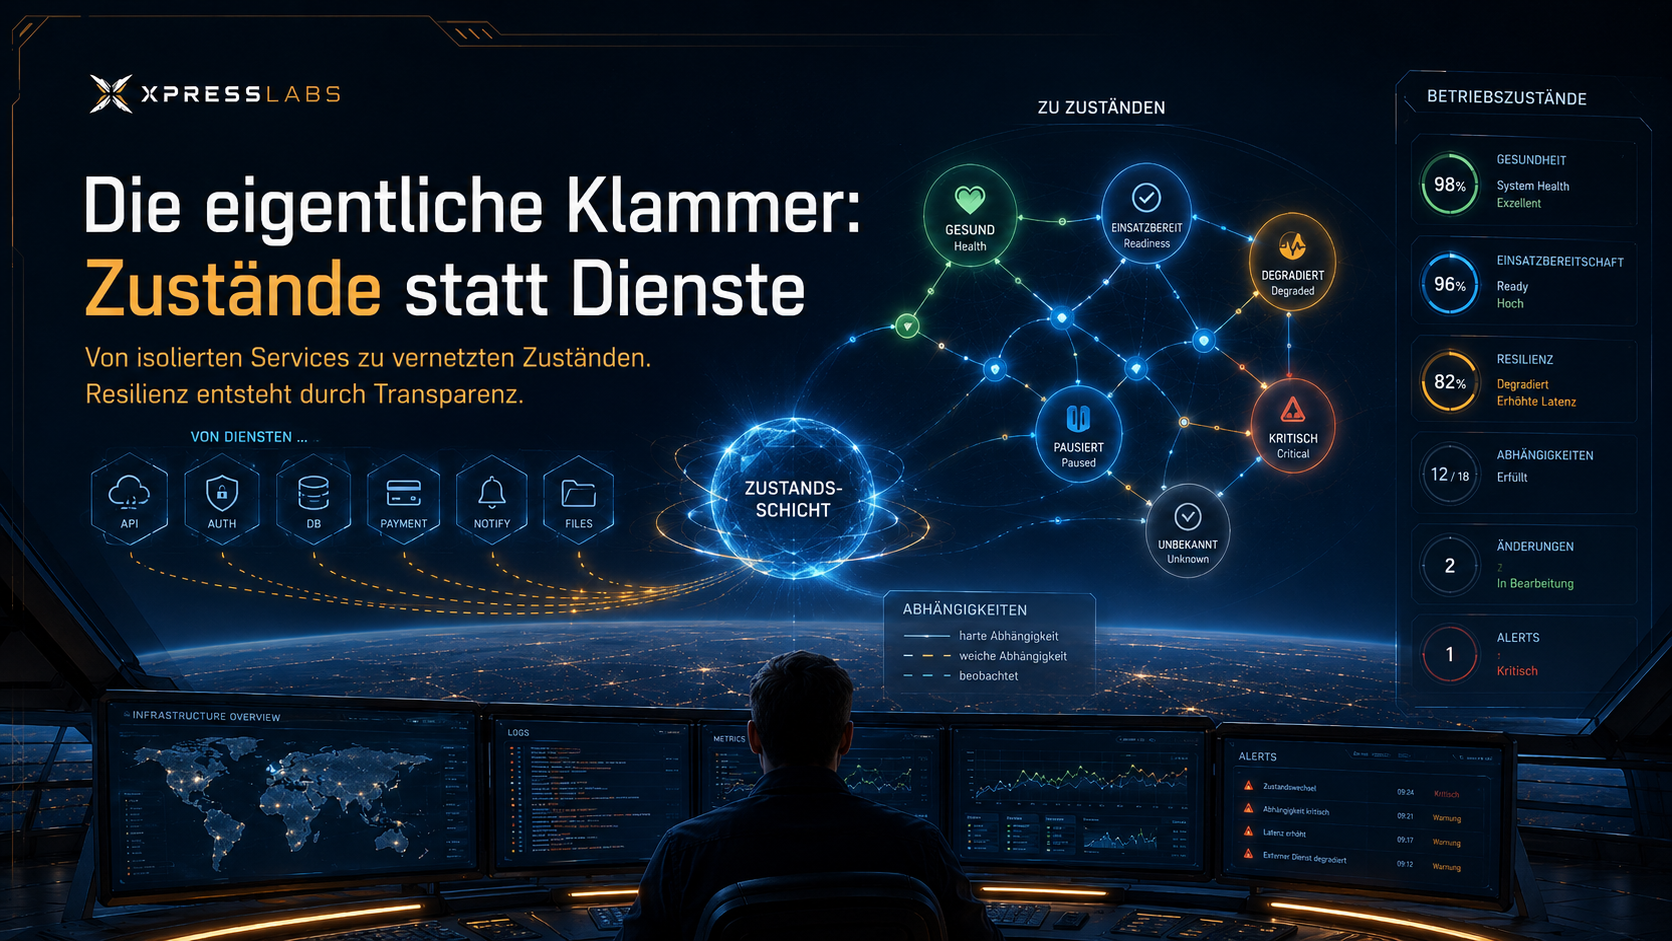
Die eigentliche Klammer: Zustände statt Dienste
Der wichtigste Denkwechsel ist für mich:
Von Diensten zu Zuständen.
Früher hätte ich eher gefragt:
Welche Dienste laufen auf welchem Node?
Heute frage ich eher:
Welche Zustände muss mein System erfüllen?
Das klingt abstrakter, ist aber in der Praxis konkreter.
Ein Dienst ist:
mariadb.service
apache2.service
syncthing.service
checkmk
wireguard
borgmatic
Ein Zustand ist:
Datenbank-Cluster ist Primary und Synced.
Webseite ist öffentlich erreichbar und liefert erwarteten Content.
DNS zeigt auf den aktiven Node.
Zertifikat ist gültig.
Backups sind aktuell und testbar.
Firewall trennt Public/VPN/Admin/Cluster sauber.
Monitoring erkennt fachliche Fehler.
Mit Zuständen kann ich arbeiten.
Ich kann sie prüfen.
Ich kann sie dokumentieren.
Ich kann sie in ein Dashboard bringen.
Ich kann sie als Failover-Voraussetzung verwenden.
Ich kann sie in Runbooks schreiben.
Ein Dienst alleine sagt mir zu wenig.
Zustände brauchen Namen
Das klingt banal, aber ich finde es wichtig: Zustände brauchen Namen.
Zum Beispiel:
NORMAL
DEGRADED
MAINTENANCE
FAILOVER_READY
FAILOVER_ACTIVE
SPLIT_BRAIN_RISK
BACKUP_ONLY
UNKNOWN
Wenn man solche Begriffe nicht definiert, benutzt man sie trotzdem irgendwie im Kopf. Dann wird es unsauber.
Was heißt “degraded” konkret?
Wann ist ein Node “ready”?
Wann darf Failover passieren?
Wann ist ein Zustand “unknown”?
Wann ist man in Maintenance und darf Alerts ignorieren?
Wenn diese Begriffe fehlen, entscheidet man im Fehlerfall spontan. Und spontan ist unter Stress selten die beste Betriebsstrategie.
Beispiel für ein kleines Zustandsmodell
Für mein Setup könnte ein stark vereinfachtes Modell so aussehen:
NORMAL:
- Primärer Node erreichbar
- Webservice antwortet korrekt
- Galera Primary
- erwartete Clustergröße erreicht
- aktiver Node Synced
- DNS zeigt auf Primary
- Backups aktuell
- Monitoring grün

DEGRADED:
- ein Node fehlt
- Cluster bleibt Primary
- Webservice erreichbar
- Backups laufen
- kein automatisches Failover nötig
- Alert sichtbar

FAILOVER_READY:
- Primary mehrfach nicht erreichbar
- Secondary erreichbar
- Secondary Webservice OK
- Secondary Galera-Zustand brauchbar
- File-Sync plausibel
- DNS-Update möglich

FAILOVER_ACTIVE:
- DNS zeigt auf Secondary
- Monitoring bestätigt neuen Pfad
- Primary wird nicht automatisch zurückgenommen
- manuelle Analyse nötig

UNKNOWN:
- widersprüchliche Checks
- DNS, Monitoring und Node-Zustände passen nicht zusammen
- keine automatische Aktion
Der wichtigste Zustand ist vielleicht UNKNOWN.
Wenn Checks widersprüchlich sind, sollte Automatisierung vorsichtig sein. Nicht jedes “ich weiß es nicht” darf automatisch zu “ich mache mal Failover” werden.
Das ist vielleicht eine der wichtigsten Regeln:
Automatisierung sollte bei Unsicherheit nicht mutiger sein als der Mensch.
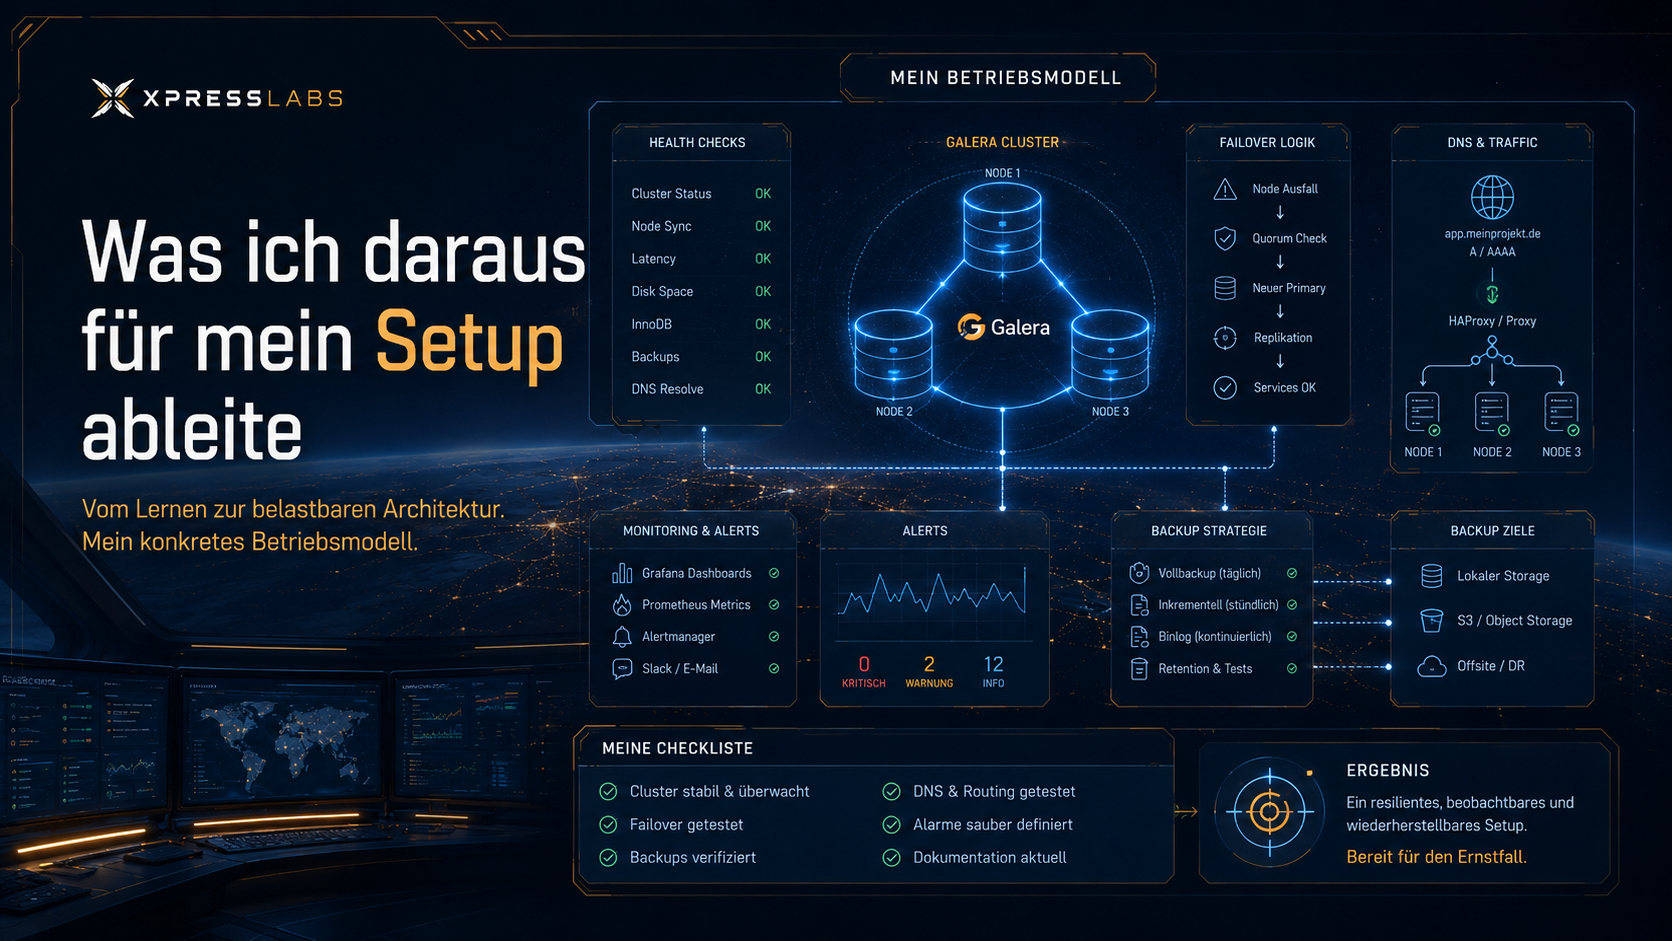
Was ich daraus für mein Setup ableite
Aus diesem Denken ergeben sich für mein Setup ein paar ziemlich klare Konsequenzen.
Health Checks müssen fachlich werden
Es reicht nicht, überall systemctl is-active zu prüfen.
Ich brauche Checks, die fachlich aussagen, ob ein Baustein seine Rolle erfüllt.
Für Galera:
Cluster Primary?
Node Synced?
wsrep_ready ON?
wsrep_connected ON?
Clustergröße plausibel?
Für Web:
Public URL erreichbar?
Statuscode korrekt?
Erwarteter Content vorhanden?
TLS gültig?
Reverse Proxy zeigt auf richtigen Backend-Zustand?
Für DNS:
Record zeigt auf erwartete IP?
Mehrere Resolver liefern plausibles Ergebnis?
Cloudflare API erreichbar?
TTL/Proxy-Status bekannt?
Für Backup:
Letzter Lauf erfolgreich?
Repository erreichbar?
Letztes Archiv plausibel?
Restore-Test dokumentiert?
Passphrase/Key verfügbar?
Für Security:
Public Ports erwartungsgemäß?
VPN erreichbar?
Cluster-Ports nur intern?
Monitoring-Pfade erlaubt?
Drop-Logs sichtbar?
Rate Limits greifen nur dort, wo sie sollen?
Das ist eine Menge. Aber nicht alles muss am ersten Tag perfekt automatisiert sein. Wichtig ist, dass das Modell stimmt.
Failover braucht Stufen
Ich will kein Failover, das bei einem Timeout sofort DNS umbiegt.
Sinnvoller ist eine Stufenlogik:
1. Einzelner Fehler erkannt
2. Wiederholung / Debounce
3. Zweite Perspektive prüfen
4. Ziel-Node prüfen
5. Maintenance-Lock prüfen
6. Entscheidung loggen
7. DNS umschalten
8. Nachkontrolle
9. Keine automatische Rückschaltung
Gerade der letzte Punkt ist wichtig.
Automatisches Failback klingt verlockend, ist aber oft gefährlicher als Failover. Wenn der alte Primary zurückkommt, heißt das nicht automatisch, dass er wieder übernehmen soll. Erst prüfen. Dann entscheiden.
Dokumentation muss in die Nähe des Codes
Ich mag keine Dokumentation, die irgendwo liegt und nie gepflegt wird.
Für solche Betriebslogik ist es besser, wenn Script, README und Check-Kommentar nah beieinander sind.
Zum Beispiel:
/opt/manage-vps/
  init/
  tools/
  docs/
  configs/
Ein Failover-Script sollte nicht nur Code enthalten. Es sollte auch erklären:
Wann darf es laufen?
Welche Checks müssen grün sein?
Was wird geändert?
Was wird bewusst nicht geändert?
Wie rolle ich zurück?
Wo stehen Logs?
Das klingt nach Overhead. Aber spätestens beim ersten echten Fehler ist man dankbar.
Monitoring muss auch die Automatisierung überwachen
Wenn ein Script DNS umschaltet, muss das Monitoring das erkennen.
Nicht nur:
DNS geändert.
Sondern:
DNS zeigt jetzt auf Secondary.
Secondary liefert Webseite.
Galera-Zustand nach Umschaltung plausibel.
Nutzerpfad funktioniert.
Wenn Automatisierung wirkt, muss Monitoring die Wirkung prüfen.
Sonst hat man nur ein Script, das Änderungen macht, aber niemand sieht, ob die Änderung wirklich das Problem gelöst hat.
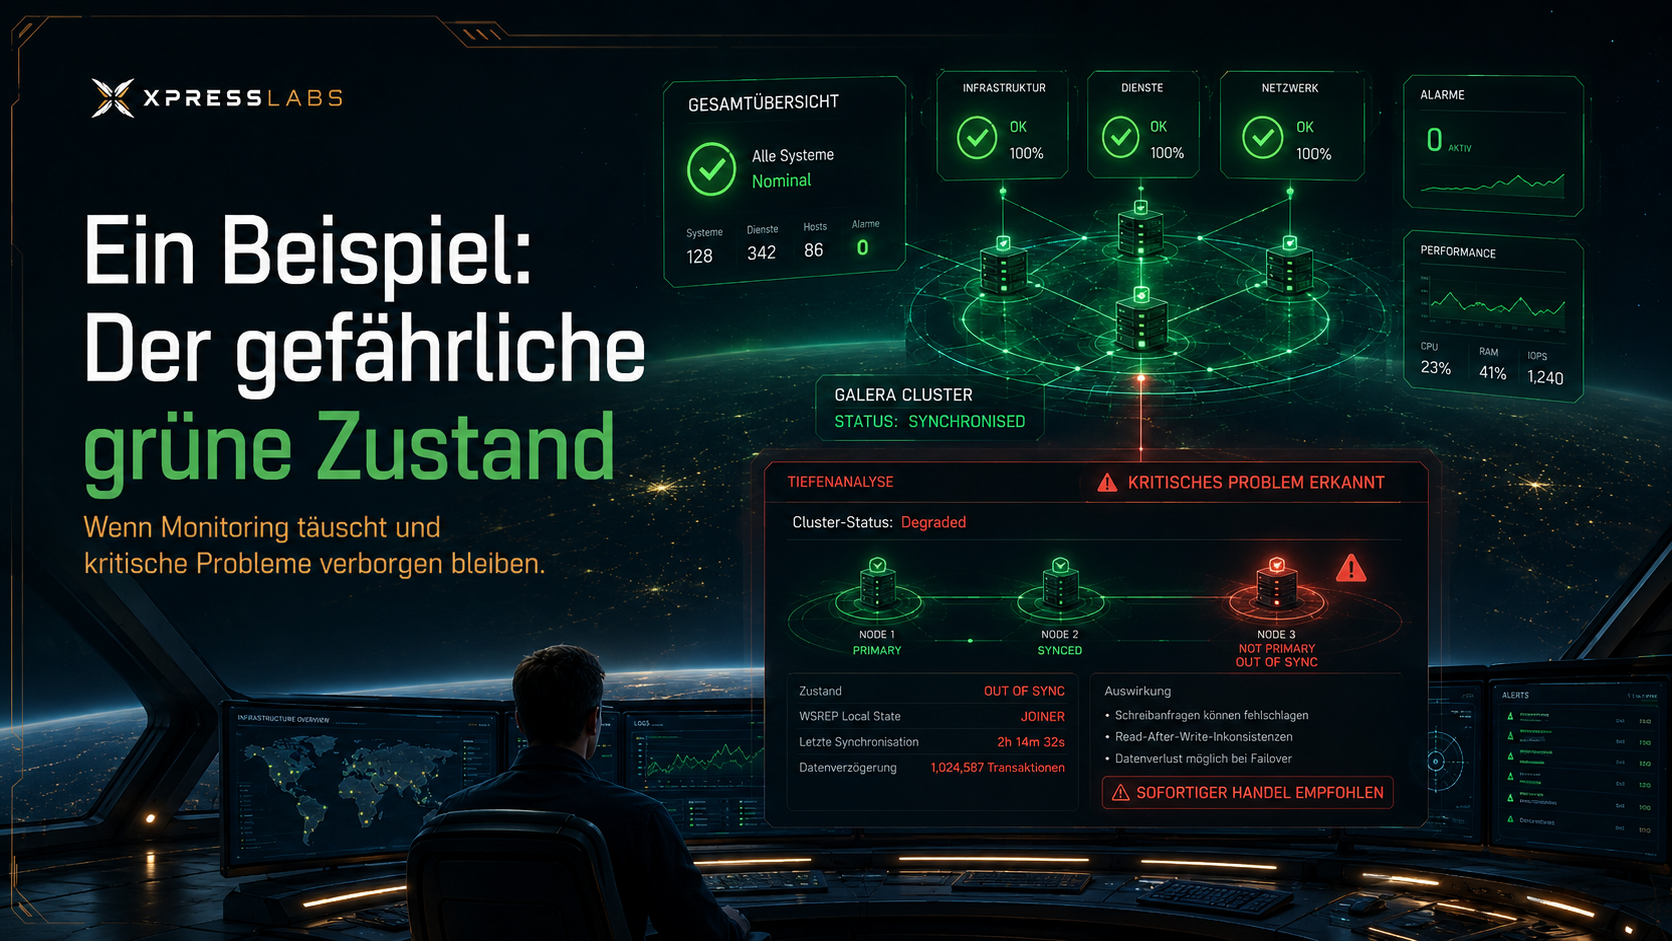
Ein Beispiel: Der gefährliche grüne Zustand
Stellen wir uns einen konkreten Fall vor.
Das Dashboard zeigt:
Web: OK
MariaDB: OK
CPU: OK
Disk: OK
Ping: OK
Backups: OK
Alles grün.
Aber darunter sieht Galera so aus:
wsrep_cluster_status = Primary
wsrep_cluster_size = 3
wsrep_ready = ON
wsrep_connected = ON
wsrep_local_state_comment = Joining
Jetzt könnte man sagen: Ist doch fast okay.
Nein.
Wenn ich für diesen Node Synced erwarte, ist Joining nicht okay. Vielleicht ist es kurzfristig okay direkt nach einem Restart. Aber dann muss es als Übergangszustand sichtbar sein. Und wenn dieser Zustand länger bleibt, muss daraus ein Alert werden.
Noch schlimmer wäre:
wsrep_cluster_status = Non-Primary
oder:
wsrep_ready = OFF
Dann ist der Node nicht einfach “ein bisschen komisch”. Dann ist das ein Zustand, den man aktiv behandeln muss.
Warum das gefährlich ist
Das Gefährliche ist nicht, dass etwas kaputt ist.
Das Gefährliche ist, dass es kaputt ist und grün aussieht.
Denn dann trifft man Entscheidungen auf falscher Basis.
Man fährt Wartung.
Man schaltet DNS um.
Man bewertet ein Backup.
Man startet einen Dienst neu.
Man nimmt an, dass der Node bereit ist.
Und genau dann wird aus einem kleinen Problem ein größeres.
Wie man es besser macht
Ein besserer Check würde nicht nur mariadb.service prüfen, sondern zwei Ebenen liefern:
MariaDB Prozess: OK
Galera Cluster State: WARNING/CRITICAL
Das Dashboard darf ruhig zeigen, dass der Prozess läuft. Aber es muss gleichzeitig zeigen, dass der Clusterzustand nicht passt.
Also nicht alles in einen grünen Punkt pressen.
Lieber differenziert:
Host: OK
Service: OK
Cluster: CRITICAL
Role: Not ready
Das ist im ersten Moment weniger hübsch. Aber es ist ehrlicher.
Und ehrliche Dashboards sind wichtiger als hübsche Dashboards.
Warum das Thema nicht nur Homelab ist
Man könnte jetzt sagen: Das ist doch alles viel zu groß für ein privates Setup.
Vielleicht.
Aber ich glaube, das Gegenteil ist der Fall.
Ein kleines Setup ist der beste Ort, um diese Prinzipien zu lernen. Weil man alle Ebenen selbst berührt.
Man merkt direkt, wenn DNS falsch ist.
Man merkt direkt, wenn die Firewall zu hart ist.
Man merkt direkt, wenn Galera nach einem Reboot nicht sauber zurückkommt.
Man merkt direkt, wenn ein Monitoring zwar schön aussieht, aber den echten Fehler nicht sieht.
Man merkt direkt, wenn Backups zwar laufen, aber keiner weiß, ob Restore funktioniert.
Das sind keine kleinen Lektionen.
Das sind genau die Dinge, die auch in großen Umgebungen passieren. Nur dort sind sie oft besser versteckt, langsamer eskaliert oder auf mehrere Teams verteilt.
Kleine Setups haben echte Fehler
Ein VPS kann ausfallen.
Eine Disk kann voll laufen.
Ein Zertifikat kann ablaufen.
Ein DNS-Record kann falsch zeigen.
Eine Firewall-Regel kann einen Dienst blockieren.
Ein Backup kann unbrauchbar sein.
Ein Cluster kann inkonsistent werden.
Das alles ist nicht weniger real, nur weil es kein Enterprise-Setup ist.
Und gerade deshalb lohnt es sich, kleine Setups ernst zu nehmen.
Nicht übertrieben. Nicht mit zehn Tools für drei Dienste. Aber mit klaren Prinzipien.
Der Unterschied zwischen Basteln und Betreiben
Ich finde den Unterschied wichtig.
Basteln ist:
Ich bekomme es irgendwie zum Laufen.
Betreiben ist:
Ich weiß, wie ich erkenne, ob es noch richtig läuft.
Basteln ist nicht schlecht. Viele gute Dinge beginnen als Bastelprojekt. Aber wenn daraus ein Dienst wird, den man wirklich nutzt, verändert sich der Anspruch.
Dann braucht man:
Updates
Backups
Monitoring
Logs
Rollback
Security
Dokumentation
Nicht alles perfekt. Aber vorhanden.
XpressLabs soll genau diese Grenze sichtbar machen.
Nicht als erhobener Zeigefinger. Eher als ehrliche Notiz:
Ich habe etwas gebaut. Nun muss ich es auch betreiben.
Die drei Fehlerklassen, die ich im Kopf behalten will
Je länger ich an solchen Setups baue, desto mehr merke ich: Viele Fehler lassen sich grob in drei Klassen sortieren.
Nicht technisch perfekt, aber praktisch.
1. Harte Ausfälle
2. Schleichende Degradation
3. Falsche Zustände
Ein harter Ausfall ist einfach.
Node weg.
Dienst down.
Disk voll.
Port zu.
DNS falsch.
Zertifikat abgelaufen.
Das sieht man meistens. Nicht immer sofort, aber irgendwann kracht es sichtbar.
Schleichende Degradation ist unangenehmer.
Ein Node ist noch da, aber langsam.
Galera ist noch Primary, aber ein Node hängt hinterher.
Disk ist noch nicht voll, aber wächst gefährlich.
Backups laufen noch, aber dauern länger.
Checks sind noch grün, aber Latenz steigt.
Ein Service antwortet noch, aber Fehlerquote nimmt zu.
Das ist der Bereich, in dem Monitoring wirklich nützlich wird. Nicht nur Alarm, wenn etwas tot ist, sondern Sichtbarkeit, bevor etwas stirbt.
Die dritte Klasse ist für mich die gefährlichste: falsche Zustände.
Das System sieht so aus, als wäre es in Zustand A, ist aber eigentlich in Zustand B.
Beispiele:
Dashboard grün, Cluster aber nicht Synced.
DNS zeigt auf Secondary, Dokumentation sagt Primary.
Backup erfolgreich, Restore aber nie getestet.
Firewall-Regel vorhanden, aber falsches Interface.
Monitoring aktiv, aber prüft den falschen Host.
Diese Fehler sind so fies, weil sie Vertrauen simulieren.
Man handelt dann auf Basis einer falschen Annahme. Und genau dadurch werden sie teuer.
Harte Ausfälle sind nicht das Hauptproblem
Das klingt vielleicht komisch, aber harte Ausfälle sind oft die einfacheren Fehler.
Wenn ein Host nicht erreichbar ist, weiß man zumindest: Da stimmt etwas nicht.
Wenn mariadb.service down ist, sieht man es.
Wenn Apache nicht startet, sieht man es.
Wenn DNS gar nicht auflöst, sieht man es.
Wenn die Disk bei 100 Prozent steht, sieht man es meistens auch ziemlich deutlich.
Der eigentliche Schmerz sind die Zustände dazwischen.
Noch erreichbar.
Noch halb gesund.
Noch grün.
Noch nicht komplett kaputt.
Das ist die Zone, in der man saubere Betriebslogik braucht.
Incident-Szenarien: Was im echten Betrieb passieren kann
Ich finde abstrakte Architektur immer etwas gefährlich, wenn sie nicht an konkreten Fehlerbildern hängt.
Also ein paar Szenarien, die ich für mein Setup im Kopf behalten will.
Nicht als Drama. Sondern als Realitätscheck.
Szenario 1: Node rebootet und kommt “fast” zurück
Ein Provider rebootet einen VPS. Oder ich starte bewusst neu. Danach sieht es erst einmal gut aus.
Ping: OK
SSH: OK
mariadb.service: active
apache2.service: active
Man könnte sagen: passt.
Aber dann zeigt Galera:
wsrep_local_state_comment = Joining
wsrep_cluster_size = 2
wsrep_ready = OFF
Das ist kein normaler Zustand.
Jetzt muss das Monitoring differenzieren:
Host OK
Service OK
Cluster WARNING/CRITICAL
Node Role NOT READY
Ein Failover-Script darf diesen Node nicht als Ziel verwenden.
Ein Mensch darf ihn auch nicht einfach als gesund abhaken.
Szenario 2: Disk läuft voll und produziert Folgefehler
Disk-full ist so ein Fehler, der nie nur Disk-full bleibt.
Erst ist nur wenig Platz frei.
Dann werden Logs größer.
Dann wachsen Binlogs.
Dann gehen Backups nicht mehr sauber durch.
Dann starten Dienste komisch.
Dann fehlen temporäre Dateien.
Dann produziert die Datenbank Folgefehler.
Und irgendwann schaut man auf fünf Symptome, obwohl die Ursache relativ banal war.
Deshalb ist Disk-Monitoring nicht nur:
Filesystem > 90 Prozent = Warning
Filesystem > 95 Prozent = Critical
Sondern auch:
Welche Pfade wachsen?
Wie schnell wachsen sie?
Sind Binlogs plausibel?
Sind Backup-Ziele getrennt?
Gibt es automatische Bereinigung?
Welche Dienste hängen an diesem Filesystem?
Ein kleiner Node mit knapper Disk ist nicht automatisch schlecht. Aber er verzeiht weniger.
Szenario 3: DNS-Failover funktioniert technisch, aber fachlich falsch
Cloudflare Record geändert.
DNS zeigt auf Secondary.
HTTP antwortet.
Alles sieht gut aus.
Aber die Anwendung verwendet Daten, die nicht aktuell sind. Oder der Secondary hatte nicht den erwarteten Datenbankzustand. Oder eine Subdomain wurde vergessen. Oder ein Reverse-Proxy-vHost zeigt noch intern auf den falschen Backend-Namen.
Technisch war das Failover erfolgreich.
Fachlich nicht.
Das ist genau der Unterschied, der in vielen automatischen Failover-Ideen zu kurz kommt.
Ein DNS-Update ist keine Verfügbarkeitsgarantie. Es ist nur ein Zeigerwechsel.
Der Zielzustand muss vorher stimmen.
Szenario 4: Security blockiert den Retter
Auch schön: Der produktive Dienst fällt aus, Monitoring erkennt es, Script möchte prüfen oder umschalten, aber irgendeine Security-Schicht blockiert genau den Pfad, den man im Incident braucht.
Beispiele:
Monitoring-Node darf den Webservice nicht extern prüfen.
Failover-Script darf Cloudflare API nicht erreichen.
Backup-Node darf nicht per SSH zugreifen.
VPN ist down, aber alle internen Checks hängen am VPN.
Rate Limit blockiert Health Checks.
Digest/OAuth schützt ein Dashboard so gut, dass es im Fehlerfall keiner schnell öffnen kann.
Das sind keine Argumente gegen Security. Das sind Argumente für bessere Security.
Security muss wissen, welche Betriebsflüsse legitim sind.
Wenn alles gleich aussieht wie Angriff, ist das System nicht sicherer. Es ist nur unbenutzbarer.
Monitoring als Entscheidungsmaschine
Ich glaube, ein wichtiger Schritt ist, Monitoring nicht nur als Anzeige zu sehen.
Monitoring ist nicht nur ein Dashboard.
Monitoring ist eine Entscheidungsmaschine.
Nicht im Sinne von “alles automatisch entscheiden”, sondern im Sinne von:
Monitoring liefert die Faktenbasis, auf der Menschen und Scripts handeln.
Wenn die Faktenbasis schlecht ist, sind die Entscheidungen schlecht.
Ein Dashboard ist also nicht nur hübsch oder informativ. Es ist Teil der Betriebslogik.
Welche Entscheidungen hängen am Monitoring?
Mehr als man denkt:
Kann ich Wartung starten?
Darf ich einen Node rebooten?
Ist ein Failover nötig?
Darf ein Failover automatisiert laufen?
Muss ich Backup prüfen?
Ist ein Fehler extern sichtbar?
Ist ein Clusterzustand kritisch oder nur Übergang?
Kann ich einen Alarm ignorieren?
Wenn Monitoring diese Fragen nicht beantworten kann, muss man im Fehlerfall manuell raten.
Und Raten unter Stress ist keine Strategie.
Gute Alerts sind selten
Ein guter Alert ist schwerer zu bauen als ein schlechter.
Ein schlechter Alert sagt:
Something is down.
Ein guter Alert sagt:
Was ist kaputt?
Warum ist das für den Betrieb relevant?
Welche Rolle ist betroffen?
Welche Prüfung hat ausgelöst?
Was sollte ich als nächstes tun?
Beispiel schlechter Alert:
MariaDB CRITICAL
Beispiel besser:
Galera Node universe4infomaniak ist nicht Synced.
wsrep_local_state_comment=Joining seit 12 Minuten.
Cluster bleibt Primary mit Größe 2/3.
Node nicht als Failover-Ziel verwenden.
Das ist länger. Aber es spart im Incident Minuten und Nerven.
Warnung vor Alert-Theater
Natürlich kann man es auch übertreiben.
Wenn jedes kleine Zucken einen Alarm auslöst, stumpft man ab. Dann ist Monitoring nur noch Lärm.
Deshalb braucht man Abstufungen:
INFO: Zustand geändert
WARNING: Zustand unerwartet, aber Dienst noch nutzbar
CRITICAL: Zustand verletzt Betriebsannahme
UNKNOWN: Check widersprüchlich oder nicht vertrauenswürdig
UNKNOWN ist wichtig.
Ein Check, der nicht sauber prüfen kann, ist nicht automatisch OK. Er ist unknown. Und unknown darf im Failover-Kontext nicht als gesund gelten.
Was ich bewusst nicht automatisieren würde
Automatisierung ist verführerisch.
Man schreibt ein Script, es prüft Dinge, es schaltet Dinge um, es repariert vielleicht sogar Dinge. Das fühlt sich gut an.
Aber manche Dinge würde ich im kleinen Setup bewusst nicht komplett automatisieren.
Kein automatisches Failback
Failover vielleicht. Failback nein.
Wenn ein Primary wieder da ist, heißt das nicht, dass er wieder übernehmen darf.
Er kann alte Daten haben.
Er kann einen kaputten Clusterzustand haben.
Er kann Dateisync-Probleme haben.
Er kann wiederkommen und trotzdem nicht vertrauenswürdig sein.
Automatisches Failback ist ein Klassiker für unnötige zweite Ausfälle.
Meine Regel wäre:
Failover darf kontrolliert automatisiert werden.
Failback bleibt manuell.
Zumindest solange das Setup nicht sehr sauber getestet ist.
Kein Repair ohne Snapshot / Backup-Kontext
Ein Script, das Dinge “repariert”, kann auch Dinge zerstören.
Gerade bei Datenbanken und Dateisynchronisierung ist Vorsicht angebracht.
Vor aggressiven Aktionen sollte klar sein:
Gibt es ein aktuelles Backup?
Was wird verändert?
Kann ich zurück?
Ist der Zustand dokumentiert?
Ein Script, das im Fehlerfall automatisch Konfigurationsdateien umschreibt oder Dienste neu initialisiert, muss sehr gut gebaut sein. Sonst hat man schnell ein Reparatur-Script, das den eigentlichen Schaden vergrößert.
Keine Security-Ausnahmen ohne Ablaufdatum
Temporäre Firewall-Regel.
Kurz OAuth umgehen.
Einmal Basic Auth deaktivieren.
Ein Test-Port offenlassen.
Einen SSH-Key schnell irgendwo eintragen.
Kennt man alles.
Das Problem ist nicht die Ausnahme. Das Problem ist, dass Ausnahmen gerne bleiben.
Deshalb sollte jede Security-Ausnahme eine Notiz bekommen:
Warum?
Für wen?
Bis wann?
Wie zurückbauen?
Wenn das zu bürokratisch klingt, reicht am Anfang auch ein Kommentar im Script oder eine kleine Markdown-Datei.
Hauptsache, man findet es wieder.
Dokumentation als Kontrollinstrument
Ich habe früher Dokumentation oft als nachgelagert gesehen.
Erst bauen, dann irgendwann dokumentieren.
Inzwischen sehe ich das anders.
Wenn ich ein Setup nicht dokumentieren kann, habe ich es wahrscheinlich nicht verstanden.
Das ist vielleicht etwas hart, aber hilfreich.
Eine gute Doku muss nicht lang sein. Sie muss die richtigen Fragen beantworten.
Was ist die Rolle dieses Dienstes?
Welche Zustände sind gesund?
Welche Checks prüfen das?
Welche Ports sind nötig?
Welche Abhängigkeiten gibt es?
Was passiert bei Ausfall?
Wie ist der Rückbau?
Wenn ich diese Fragen nicht beantworten kann, sollte ich vielleicht noch kein automatisches Failover darauf bauen.
Kommentare in Scripts sind keine Schwäche
Gerade bei Bash-Scripts mag ich ausführliche Header.
Nicht weil Shellscripts dadurch eleganter werden. Werden sie nicht.
Sondern weil man nach drei Monaten nicht mehr weiß, warum ein Parameter so gesetzt wurde.
Ein guter Script-Header erklärt:
Zweck
Scope
Voraussetzungen
Was wird geändert
Was wird nicht geändert
Rollback
Version History
Das ist langweilig. Bis man es braucht.
Dann ist es Gold wert.
Der eigentliche Zielzustand
Wenn ich den Zielzustand in einem Satz formulieren müsste:
Ich möchte ein Setup, bei dem ich im Fehlerfall nicht raten muss.
Nicht perfekt. Nicht vollautomatisch. Nicht Enterprise. Aber auch nicht blind.
Ich möchte wissen:
Welcher Zustand ist gerade verletzt?
Welche Rolle ist betroffen?
Welche Checks stützen diese Aussage?
Welche Aktion ist sicher?
Welche Aktion ist gefährlich?
Wie komme ich zurück?
Wenn ein Setup mir diese Fragen beantwortet, ist es für mich viel wert.
Dann darf es auch klein sein. Dann darf es auch aus Bash-Scripts, Markdown-Dateien und pragmatischen Checks bestehen.
Wichtig ist nicht, dass es nach Enterprise aussieht.
Wichtig ist, dass es ehrlich ist.
Was hier noch fehlt
Natürlich ist damit nicht alles gelöst.
Ein paar Themen bleiben offen und müssen in eigenen Beiträgen tiefer auseinander:
Wie tief soll automatisches Failover wirklich gehen?
Wann ist manuelles Eingreifen besser?
Wie verhindert man Split-Brain?
Wie oft muss ein Restore-Test wirklich laufen?
Wie trennt man Monitoring, Backup und Admin-Zugriffe sauber?
Welche Plattform ist langfristig sinnvoll: Checkmk, PMM, Prometheus, Zabbix?
Wie dokumentiert man Betriebszustände, ohne ein Bürokratiemonster zu bauen?
Wie viel Security ist genug, ohne den Alltag zu ruinieren?
Das sind keine Nebenthemen. Das sind eigentlich die nächsten Deep Dives.
Gerade Monitoring ist ein eigenes Fass. Checkmk ist stark für klassische Host- und Service-Sicht. Prometheus ist stark für Metriken und Zeitreihen. PMM ist spannend für Datenbankdetails. Zabbix kann ebenfalls viel, ist aber wieder eine eigene Welt. Netdata ist schnell und angenehm für lokale Live-Sicht.
Die Frage ist nicht nur:
Welches Tool ist besser?
Sondern:
Welche Betriebsfrage will ich beantworten?
Das ist wieder dasselbe Muster.
Tool folgt Zustand. Nicht umgekehrt.
Mein aktueller Zwischenstand
Wenn ich das auf mein Setup runterbreche, würde ich den Zielzustand so formulieren:
Ich möchte ein kleines, aber ernsthaft betreibbares VPS-Setup.
Das heißt für mich:
mehrere Nodes
klare Rollen
interne Kommunikation über VPN
öffentliche Dienste über Reverse Proxy
Datenbankzustand sichtbar
DNS-Failover kontrolliert
Backups vorhanden und prüfbar
Monitoring mit fachlichen Checks
Security mit Zonenmodell
Dokumentation direkt am Setup
Das ist nicht “Enterprise”. Es ist auch nicht “nur Homelab”.
Es ist irgendwo dazwischen.
Vielleicht ist genau das der interessante Bereich.
Klein genug, dass man alles noch selbst verstehen kann.
Groß genug, dass Fehler echte Konsequenzen haben.
Praktisch genug, dass man daraus brauchbare Notizen schreiben kann.
Fazit
Galera, Monitoring, DNS und Security sind keine getrennten Inseln.
Sie hängen zusammen.
Und wenn man sie getrennt betrachtet, entstehen genau die Lücken, die später im Betrieb weh tun.
Die Datenbank muss nicht nur laufen, sondern im richtigen Cluster-Zustand sein.
Monitoring muss nicht nur Ports prüfen, sondern Betriebsannahmen abbilden.
DNS darf nicht blind Failover spielen.
Security darf nicht so hart sein, dass sie den Betrieb sabotiert oder Monitoring blind macht.
Für mich ist die eigentliche Erkenntnis:
Infrastruktur besteht nicht aus installierten Diensten, sondern aus überprüfbaren Zuständen.
Das klingt vielleicht trocken. Aber im Alltag ist es genau der Unterschied zwischen:
Irgendwie läuft es.
und:
Ich weiß, warum ich dem Zustand gerade vertraue.
Und genau darum geht es bei XpressLabs.
Nicht nur:
Wie installiere ich etwas?
Sondern:
Wie betreibe ich es so, dass ich Fehler sehe, verstehe und wieder rauskomme?
Das ist der Unterschied zwischen einem Setup, das heute funktioniert, und einem Setup, dem man auch morgen noch halbwegs vertrauen kann.
Technische Anker / Quellen
Diese Notiz ist bewusst kein offizielles Produkt-How-to, sondern ein eigener Deep Dive. Für die technischen Grundannahmen sind insbesondere relevant:
- MariaDB Galera Cluster Status Variables
- MariaDB: Monitoring MariaDB Galera Cluster
- Cloudflare DNS Records und DNS Record API
- Cloudflare TTL-Verhalten bei proxied Records
- Checkmk Active Checks
- Prometheus Blackbox Exporter
Anhang: Meine praktische Checkliste für solche Setups
Ich würde diesen Artikel nicht ernst nehmen, wenn am Ende nur abstrakte Sätze stehen würden.
Also hier noch einmal als Arbeitsliste. Nicht perfekt. Nicht vollständig. Aber deutlich näher an dem, was ich tatsächlich prüfen möchte.
Web / Reverse Proxy
Public URL erreichbar
HTTP -> HTTPS Redirect korrekt
TLS gültig
richtiger vHost aktiv
erwarteter Content vorhanden
Backend erreichbar
Logs plausibel
keine unerwarteten 403/404/502
Ein curl -I reicht als Einstieg:
curl -I https://example.tld/
Besser ist zusätzlich ein Content-Check:
curl -fsSL https://example.tld/ | grep -q "erwarteter-string"
Nicht schön, aber praktisch.
Galera / MariaDB
mariadb.service aktiv
lokale Verbindung möglich
wsrep_cluster_status = Primary
wsrep_local_state_comment = Synced
wsrep_ready = ON
wsrep_connected = ON
wsrep_cluster_size plausibel
keine offensichtlichen SST/IST Fehler im Log
Kompakter SQL-Check:
sudo mysql -NBe "
SHOW STATUS WHERE Variable_name IN (
  'wsrep_cluster_status',
  'wsrep_cluster_size',
  'wsrep_local_state_comment',
  'wsrep_ready',
  'wsrep_connected'
);
"
Wichtig ist nicht nur die Ausgabe, sondern die Bewertung.
Wenn ich Synced erwarte und Joining bekomme, ist das kein OK. Es ist höchstens ein Übergangszustand.
DNS
Cloudflare Record korrekt
lokale Auflösung korrekt
externe Resolver plausibel
Primary/Secondary Erwartung stimmt
TTL bekannt
Proxy-Status bekannt
kein falscher CNAME/A Konflikt
Beispiel:
dig +short example.tld
dig @1.1.1.1 +short example.tld
dig @8.8.8.8 +short example.tld
Ich weiß, 8.8.8.8 ist nicht mein Lieblingsresolver. Aber als externe Gegenprobe ist so etwas manchmal praktisch.
Firewall / Zonen
Public SSH nur auf gewünschtem Port
Root Login aus
VPN Interface erlaubt interne Dienste
Galera Ports nicht öffentlich
Monitoring darf prüfen
Backup darf schreiben/lesen wie geplant
Drop-Logs sichtbar
Rate Limits treffen nicht VPN/Cluster
Die entscheidende Frage ist nicht “ist die Firewall streng?”, sondern:
Ist sie an den richtigen Stellen streng?
Backup
Borg Repository erreichbar
letzter Lauf erfolgreich
Repository nicht voll
Passphrase/Key vorhanden
Retention plausibel
Restore-Test geplant oder durchgeführt
Backup-User eingeschränkt
Logs sichtbar
Ein Backup ohne Restore-Test ist für mich eher eine Hoffnung als eine Strategie.
Das klingt hart, aber es stimmt.
Failover
Fehler mehrfach bestätigt
Ziel-Node geprüft
Datenbankzustand geprüft
Webzustand geprüft
DNS-Update möglich
Maintenance-Lock geprüft
Aktion geloggt
Nachkontrolle durchgeführt
kein automatisches Failback
Gerade der letzte Punkt ist mir wichtig.
Automatisches Failback klingt nach High Availability, kann aber sehr schnell Chaos erzeugen.
Wenn der alte Node wiederkommt, muss er erst analysiert werden. Er darf nicht einfach wieder übernehmen, nur weil er wieder pingbar ist.
Kleine persönliche Wahrheit zum Schluss
Ich habe früher oft gedacht, dass Dokumentation das ist, was man macht, wenn das Setup fertig ist.
Heute sehe ich das anders.
Dokumentation ist ein Teil davon, ein Setup fertig zu machen.
Wenn ich nicht erklären kann, warum ein Check existiert, ist der Check wahrscheinlich nicht sauber genug.
Wenn ich nicht erklären kann, wann ein Script laufen darf, ist das Script zu gefährlich.
Wenn ich nicht erklären kann, was ein grüner Zustand bedeutet, ist das Dashboard nur Deko.
Das ist vielleicht die wichtigste Lektion aus solchen Projekten.
Technik ist selten das Problem allein.
Das Problem ist meistens die Kombination aus Technik, Annahmen, fehlender Sichtbarkeit und zu viel Vertrauen in “wird schon passen”.
Und genau deshalb lohnt sich dieser Deep Dive.
Nicht weil Galera, DNS, Monitoring und Security besonders exotisch wären.
Sondern weil sie zusammen sehr schnell zeigen, ob man nur installiert — oder wirklich betreibt.